5 Pré-processamento
O arquivo helpers.R carrega os pacotes compartilhados pelo projeto. Os parâmetros específicos desta análise são definidos nos chunks em que são utilizados, para que o leitor possa acompanhar a origem de cada decisão. Cada saída é produzida depois da operação que a fundamenta e recebe, no HTML, um callout com a explicação dos objetos, funções, argumentos e parâmetros.
O pré-processamento em questionários de autorelato tem como finalidade proteger as análises vindouras de vieses introduzidos por respostas descuidadas ou com esforço insuficiente (Careless or Insufficient Effort Responding — C/IER), registros incompletos ou com respostas inconsistentes, e a inspeção preliminar das variáveis para prospecção de problemas. Nas seções anteriores não precisamos dos dados coletados, mas a partir de agora, temos que fazer exercícios com dados brutos, e por isso, vamos utilizar a mesma base de dados empregada por Rogers (2024) e Rogers (2022).
Nesse tutorial, entretanto, o processamento parte dos 1.546 registros brutos e explicita tanto os critérios procedurais (ex-ante) quanto os indicadores estatísticos (ex-post) de triagem C/IER. Como os trabalhos anteriores (Rogers, 2022, 2024) partiram de uma base pré-processada de 1.047 participantes, eventuais diferenças entre seus resultados e os deste tutorial não devem ser atribuídas exclusivamente ao tratamento ordinal ou contínuo dos itens. Após a verificação da integridade do banco e a remoção de registros sem identificação ou com mais de cinco respostas ausentes na WHOQOL-Bref (como veremos adiante, o objetivo é simular estimação com dados missings), a amostra elegível foi submetida a um protocolo sequencial de triagem C/IER.
O chunk data-preparation importa o arquivo bruto com read_csv2(), cria os vetores que identificam os itens da escala e de atenção, verifica a presença das colunas obrigatórias e interrompe a execução com cli_abort() se alguma estiver ausente. Em seguida, converte as respostas para formato numérico, transforma os timestamps com as.POSIXct(), calcula a duração em segundos com difftime() e cria a flag dropout. O objeto eligible_data mantém apenas os registros com identificação e no máximo cinco respostas ausentes nos 26 itens da escala. Por fim, dir.create() garante a existência do diretório e write_csv2() salva essa base intermediária no projeto.
Código
raw_data <- read_csv2(
  here::here("Data", "InputData", "data.csv"),
  show_col_types = FALSE
)

scale_items <- paste0("Q", 1:26)
attention_items <- paste0("CQ", 1:3)

required_columns <- c(
  "ID", "CREATED", "MODIFIED", attention_items, scale_items
)
missing_columns <- setdiff(required_columns, names(raw_data))
if (length(missing_columns) > 0) {
  cli::cli_abort(
    "As colunas obrigatórias ausentes são: {paste(missing_columns, collapse = ', ')}"
  )
}

prepared_data <- raw_data |>
  mutate(
    dropout = is.na(ID) | rowSums(is.na(pick(all_of(scale_items)))) > 5,
    created_dt = as.POSIXct(
      CREATED, format = "%d/%m/%Y %H:%M", tz = "UTC"
    ),
    modified_dt = as.POSIXct(
      MODIFIED, format = "%d/%m/%Y %H:%M", tz = "UTC"
    ),
    TIME = as.numeric(difftime(
      modified_dt, created_dt, units = "secs"
    )),
    across(all_of(c(attention_items, scale_items)), as.numeric)
  )

eligible_data <- prepared_data |>
  filter(!dropout)

dir.create(here::here("Data", "IntermediateData"), showWarnings = FALSE)

write_csv2(
  eligible_data,
  here::here("Data", "IntermediateData", "whoqol_eligible.csv")
)
Para o tratamento dos indivíduos com C/IER adotou-se a abordagem de múltiplos obstáculos (Multiple-hurdle Approach) indicada por Curran (2016) e DeSimone et al. (2015). Como os índices de desatenção mensuram manifestações comportamentais distintas, como respostas aleatórias, padrões invariantes e preenchimento apressado, e podem apresentar correlações baixas ou nulas entre si (Biemann et al., 2025; Goldammer et al., 2020; Meade & Craig, 2012), a literatura recomenda a aplicação combinada de critérios de triagem (Arthur et al., 2021; Curran, 2016; Ulitzsch et al., 2022). No presente tutorial, cada critério foi tratado como uma barreira obrigatória, de modo que a falha em qualquer obstáculo determinou a exclusão do participante da amostra final (Curran, 2016; Goldammer et al., 2020).
5.1 Exclusões procedurais
No âmbito dos controles ex-ante, utilizamos itens de atenção inseridos no questionário e a duração total de preenchimento da pesquisa. (Curran, 2016; Ward & Meade, 2023). A falha em pelo menos dois dos três itens de atenção incluídos foi interpretada como evidência de C/IER (Chauliac et al., 2023; DeSimone et al., 2015). Também foram excluídos os questionários de indivíduos com velocidade inferior a quatro segundos por item, limiar considerado incompatível com o processamento semântico reflexivo requerido pelo instrumento (Curran, 2016; Huang et al., 2012; Jones et al., 2023).
O chunk hurdle-procedural seleciona o identificador, os itens de atenção, a duração e os itens da escala. rowSums() conta as respostas incorretas nos controles; fail_attention sinaliza pelo menos duas falhas, enquanto fail_time sinaliza TIME < 416, equivalente a quatro segundos por item no questionário completo de 104 itens. O objeto resultante é salvo com write_csv2() como base intermediária dos critérios procedurais.
Código
procedural_data <- eligible_data |>
  select(ID, all_of(attention_items), TIME, all_of(scale_items)) |>
  mutate(
    qc_failures = rowSums(across(all_of(attention_items), ~ .x != 1),
                           na.rm = TRUE),
    fail_attention = qc_failures >= 2,
    fail_time = TIME < 416
  )

write_csv2(
  procedural_data,
  here::here("Data", "IntermediateData", "whoqol_procedural.csv")
)
5.2 Critérios estatísticos
Como critérios ex-post empregamos a medida de Longstring, o IRV e a Distância de Mahalanobis (Biemann et al., 2025; Dunn et al., 2018). O primeiro permite identificar padrões mecânicos de marcação uniforme; o segundo detecta tanto variabilidade anormalmente baixas quanto dispersão alta; e o terceiro identifica padrões multivariados distantes do comportamento normativo da amostra, condizentes com aleatoriedade excesiva (Curran, 2016; DeSimone et al., 2015; Hong et al., 2020; Meade & Craig, 2012). Considerou-se problemática uma sequência contínua (Longstring) superior à metade dos itens da WHOQOL-BREF; para o IRV, utilizaram-se os percentis 1% e 99%; e, para a Distância de Mahalanobis, o percentil 99%. Esses limiares foram definidos a priori com base na extensão da escala e nas caudas extremas das distribuições amostrais, buscando equilibrar sensibilidade à desatenção e preservação de respondentes sinceros (Arthur et al., 2021; Goldammer et al., 2020; Steedle, 2018).
O chunk indicator-calculation calcula, antes da recodificação dos itens invertidos, Longstring com careless::longstring(), IRV com careless::irv() e a distância multivariada com modi::MDmiss(). quantile() obtém os limites amostrais do IRV e da distância de Mahalanobis; em seguida, mutate() cria as três flags estatísticas. A seleção final reúne os indicadores e suas flags, e write_csv2() salva essa base para auditoria. O chunk seguinte resume esses valores na tabela de estatísticas e pontos de corte.
Código
indicator_data <- procedural_data |>
  mutate(
    longstring = as.integer(careless::longstring(pick(all_of(scale_items)))),
    irv = as.numeric(careless::irv(
      pick(all_of(scale_items)), split = FALSE
    )),
    mahalanobis = as.numeric(modi::MDmiss(
      data = as.matrix(pick(all_of(scale_items))),
      center = colMeans(pick(all_of(scale_items)), na.rm = TRUE),
      cov = cov(pick(all_of(scale_items)), use = "pairwise.complete.obs")
    ))
  )

irv_cutoffs <- quantile(
  indicator_data$irv, probs = c(.01, .99), na.rm = TRUE,
  names = FALSE, type = 7
)
mahalanobis_cutoff <- quantile(
  indicator_data$mahalanobis, probs = .99, na.rm = TRUE,
  names = FALSE, type = 7
)

screened_data <- indicator_data |>
  mutate(
    fail_longstring = longstring > 13,
    fail_irv = irv <= irv_cutoffs[[1]] | irv >= irv_cutoffs[[2]],
    fail_mahalanobis = mahalanobis >= mahalanobis_cutoff
  )

write_csv2(
  screened_data |>
    select(ID, longstring, irv, mahalanobis, fail_longstring,
           fail_irv, fail_mahalanobis),
  here::here("Data", "IntermediateData", "whoqol_indicators.csv")
)| Indicador | Média | Desvio-padrão | Mediana | 1º percentil | 99º percentil | Regra de exclusão |
|---|---|---|---|---|---|---|
| Longstring | 5.216 | 2.734 | 4.000 | 2.000 | 15.000 | longstring > 13 |
| IRV | 1.025 | 0.207 | 1.027 | 0.552 | 1.491 | IRV ≤ p1 ou IRV ≥ p99 |
| Distância de Mahalanobis | 26.000 | 15.336 | 22.060 | 5.844 | 80.639 | Mahalanobis ≥ p99 |
O chunk constrói a tabela indicator_cutoffs a partir dos indicadores calculados no chunk anterior. Para cada índice, mean(), sd() e median() resumem a tendência central e a dispersão; quantile() obtém os percentis inferior e superior observados na amostra elegível. A coluna Regra de exclusão registra o critério que será usado na triagem, sem transformar essa tabela descritiva em uma nova etapa de decisão. Em seguida, dir.create() garante a existência da pasta de resultados, write_csv2() exporta a tabela completa para o projeto e mutate(across(...)) arredonda apenas a cópia exibida no HTML antes de knitr::kable() renderizar o output.
Código
indicator_cutoffs <- tibble(
  Indicador = c("Longstring", "IRV", "Distância de Mahalanobis"),
  Média = c(mean(indicator_data$longstring, na.rm = TRUE),
            mean(indicator_data$irv, na.rm = TRUE),
            mean(indicator_data$mahalanobis, na.rm = TRUE)),
  `Desvio-padrão` = c(sd(indicator_data$longstring, na.rm = TRUE),
                      sd(indicator_data$irv, na.rm = TRUE),
                      sd(indicator_data$mahalanobis, na.rm = TRUE)),
  Mediana = c(median(indicator_data$longstring, na.rm = TRUE),
              median(indicator_data$irv, na.rm = TRUE),
              median(indicator_data$mahalanobis, na.rm = TRUE)),
  `1º percentil` = c(quantile(indicator_data$longstring, .01, na.rm = TRUE),
                     irv_cutoffs[[1]],
                     quantile(indicator_data$mahalanobis, .01, na.rm = TRUE)),
  `99º percentil` = c(quantile(indicator_data$longstring, .99, na.rm = TRUE),
                      irv_cutoffs[[2]], mahalanobis_cutoff),
  `Regra de exclusão` = c(
    "longstring > 13",
    "IRV ≤ p1 ou IRV ≥ p99",
    "Mahalanobis ≥ p99"
  )
)


dir.create(here::here("Output", "Results", "Tables"),
           recursive = TRUE, showWarnings = FALSE)

write_csv2(
  indicator_cutoffs,
  here::here("Output", "Results", "Tables", "tbl-indicator-cutoffs.csv")
)

indicator_cutoffs |> mutate(across(where(is.numeric), ~ round(.x, 3))) |>
  knitr::kable()
5.2.1 Decisão final e amostra de análise
Após o cálculo dos indicadores de atenção, velocidade, invariância e discrepância multivariada, cada participante foi avaliado simultaneamente nos cinco obstáculos definidos no protocolo. A decisão de exclusão foi aplicada de forma conservadora: a falha em qualquer uma das barreiras foi suficiente para classificar o respondente como incompatível com a amostra de análise. A Tabela 5.2 resume a frequência de sinalização em cada critério e permite avaliar quais manifestações de resposta descuidada foram mais comuns na amostra elegível. As sinalizações associadas aos itens de atenção e ao IRV foram as mais frequentes, enquanto o tempo de resposta apresentou menor incidência. Essa distribuição reforça a utilidade da estratégia de múltiplos obstáculos, pois os critérios não identificam exatamente os mesmos participantes nem representam uma única forma de comportamento inadequado.
| Critério | N sinalizado | Percentual (%) |
|---|---|---|
| Itens de atenção | 28 | 2.1 |
| Tempo de resposta | 8 | 0.6 |
| Longstring | 21 | 1.6 |
| IRV | 28 | 2.1 |
| Distância de Mahalanobis | 14 | 1.1 |
O chunk começa com screened_data, que contém os indicadores e as flags dos cinco obstáculos. rowSums(across(starts_with("fail_"))) conta quantas barreiras foram falhadas por participante; como a regra é de múltiplos obstáculos, exclude = hurdles_failed > 0 exclui qualquer participante que falhe em pelo menos uma barreira. A função pmap_chr() percorre as cinco flags na mesma linha, seleciona os nomes dos critérios sinalizados e os concatena em evidence, produzindo um registro auditável da decisão individual.
Em seguida, intermediate_data preserva a base com os indicadores, flags, contagem de falhas e evidências. criterion_summary agrega as flags por critério, calcula o número de participantes sinalizados e o percentual em relação à amostra elegível. dir.create() prepara os diretórios; os dois primeiros write_csv2() salvam a base intermediária e o log de exclusões; por fim, mutate() arredonda apenas a cópia apresentada, knitr::kable() gera a tabela e o último write_csv2() preserva a tabela completa no projeto.
Código
screened_data <- screened_data |>
  mutate(
    hurdles_failed = rowSums(across(starts_with("fail_"))),
    exclude = hurdles_failed > 0,
    evidence = pmap_chr(
      pick(fail_attention, fail_time, fail_longstring,
           fail_irv, fail_mahalanobis),
      \(...) {
        labels <- c("atenção", "tempo", "longstring", "IRV", "Mahalanobis")
        str_c(labels[c(...)], collapse = " + ") |> na_if("")
      }
    )
  )

intermediate_data <- screened_data
criterion_summary <- tibble(
  Critério = c("Itens de atenção", "Tempo de resposta", "Longstring", "IRV",
               "Distância de Mahalanobis"),
  `N sinalizado` = c(
    sum(screened_data$fail_attention), sum(screened_data$fail_time),
    sum(screened_data$fail_longstring), sum(screened_data$fail_irv),
    sum(screened_data$fail_mahalanobis)
  )
) |>
  mutate(`Percentual (%)` = `N sinalizado` / nrow(screened_data) * 100)

dir.create(here::here("Data", "IntermediateData"), showWarnings = FALSE)

dir.create(here::here("Output", "DataAppendixOutput", "Tables"),
           recursive = TRUE, showWarnings = FALSE)

write_csv2(intermediate_data, here::here(
  "Data", "IntermediateData", "whoqol_preprocessed.csv"
))

write_csv2(intermediate_data |> filter(exclude), here::here(
  "Output", "DataAppendixOutput", "Tables", "exclusion_log.csv"
))

criterion_summary |> mutate(`Percentual (%)` = round(`Percentual (%)`, 1)) |>
  knitr::kable()

write_csv2(
  criterion_summary,
  here::here("Output", "Results", "Tables", "tbl-hurdle-summary.csv")
)
A aplicação conjunta dos cinco obstáculos produziu uma redução amostral de 1.546 para 1.243 participantes. Dos 1.546 registros brutos, 223 foram removidos na etapa preliminar por não apresentarem condições mínimas de utilização da escala. Entre os 1.323 respondentes elegíveis aos obstáculos, 80 falharam em pelo menos um critério e foram excluídos da análise. Essa trajetória mostra que a maior redução ocorreu antes da aplicação dos indicadores de C/IER, enquanto a triagem comportamental posterior produziu uma exclusão proporcionalmente menor e concentrada em padrões considerados incompatíveis com a resposta cuidadosa. A Tabela 5.3 apresenta essa trajetória.
| Etapa | N |
|---|---|
| Banco bruto | 1546 |
| Dropouts removidos | 223 |
| Elegíveis aos obstáculos | 1323 |
| Excluídos por pelo menos um obstáculo | 80 |
| Amostra analítica final | 1243 |
O chunk parte de screened_data, que já contém a decisão criada no chunk anterior. filter(!exclude) retém somente os participantes que superaram todas as barreiras; select() mantém o identificador e os itens da escala; e mutate(across(...)) recodifica os itens invertidos para a direção analítica final. O objeto sample_summary registra a trajetória desde o banco bruto até a amostra final usando nrow() e sum() sobre as flags de exclusão.
dir.create() garante a existência do diretório da base analítica, e write_csv2() salva final_analysis_data para reutilização nos capítulos de mensuração. stopifnot() verifica a correspondência entre o número de linhas da base final e a regra de exclusão, além de confirmar a presença de um identificador em cada registro. Por fim, knitr::kable() apresenta a tabela e outro write_csv2() salva a trajetória amostral em formato tabular.
Código
final_analysis_data <- screened_data |>
  filter(!exclude) |>
  select(ID, all_of(scale_items)) |>
  mutate(across(all_of(c("Q3", "Q4", "Q26")), ~ 6 - .x))

sample_summary <- tibble(
  Etapa = c("Banco bruto", "Dropouts removidos", "Elegíveis aos obstáculos",
            "Excluídos por pelo menos um obstáculo", "Amostra analítica final"),
  N = c(nrow(raw_data), sum(prepared_data$dropout), nrow(indicator_data),
        sum(intermediate_data$exclude), nrow(final_analysis_data))
)

dir.create(here::here("Data", "AnalysisData"), showWarnings = FALSE)

write_csv2(final_analysis_data, here::here(
  "Data", "AnalysisData", "whoqol_analysis.csv"
))

stopifnot(
  nrow(final_analysis_data) == sum(!intermediate_data$exclude),
  !anyNA(final_analysis_data$ID)
)

sample_summary |> knitr::kable()

write_csv2(
  sample_summary,
  here::here("Output", "Results", "Tables", "tbl-analysis-sample-summary.csv")
)
5.3 Descrição dos itens
Com a amostra de análise definida, a etapa seguinte consistiu em avaliar o comportamento empírico dos itens que serão utilizados na AFC. Essa descrição deve ser utilizada para verificar a quantidade de respostas disponíveis, a tendência central, a dispersão e a forma das distribuições, fornecendo informações para a escolha do procedimento de estimação, por exemplo. Em geral, os itens apresentaram médias acima do ponto médio da escala e dispersão suficiente para preservar diferenças individuais nas respostas. A quantidade de respostas válidas variou entre os itens, porém com baixissima incidência, razão para não eliminar participantes que permanecem elegíveis para a análise. Esses resultados são apresentados na Tabela 5.4.
| Item | Respostas válidas | Média | Desvio-padrão | Assimetria | Curtose | VIF |
|---|---|---|---|---|---|---|
| Q3 | 1242 | 4.136 | 0.941 | -0.910 | 0.076 | 1.624 |
| Q4 | 1241 | 4.089 | 1.009 | -0.983 | 0.183 | 1.473 |
| Q5 | 1230 | 3.283 | 0.818 | -0.472 | -0.008 | 2.140 |
| Q6 | 1238 | 3.895 | 0.974 | -0.871 | 0.534 | 1.752 |
| Q7 | 1241 | 3.586 | 0.858 | -0.489 | 0.059 | 1.706 |
| Q8 | 1240 | 2.933 | 0.979 | -0.098 | -0.459 | 1.317 |
| Q9 | 1239 | 3.471 | 0.884 | -0.569 | 0.216 | 1.475 |
| Q10 | 1241 | 3.587 | 0.903 | -0.164 | -0.368 | 2.226 |
| Q11 | 1241 | 3.798 | 0.996 | -0.615 | -0.087 | 1.611 |
| Q12 | 1242 | 3.414 | 1.099 | -0.241 | -0.530 | 1.825 |
| Q13 | 1243 | 3.896 | 0.828 | -0.570 | 0.235 | 1.545 |
| Q14 | 1240 | 3.331 | 0.956 | -0.281 | -0.245 | 1.927 |
| Q15 | 1243 | 4.398 | 0.807 | -1.513 | 2.455 | 1.504 |
| Q16 | 1232 | 3.485 | 1.035 | -0.124 | -1.165 | 1.430 |
| Q17 | 1242 | 3.711 | 0.921 | -0.504 | -0.538 | 3.689 |
| Q18 | 1243 | 3.730 | 0.955 | -0.488 | -0.659 | 3.247 |
| Q19 | 1240 | 3.691 | 0.942 | -0.400 | -0.706 | 2.661 |
| Q20 | 1239 | 3.608 | 0.891 | -0.237 | -0.674 | 1.893 |
| Q21 | 1242 | 3.420 | 1.009 | -0.003 | -1.111 | 1.316 |
| Q22 | 1241 | 3.554 | 0.884 | -0.131 | -0.703 | 1.730 |
| Q23 | 1237 | 3.973 | 0.949 | -0.686 | -0.413 | 1.392 |
| Q24 | 1242 | 3.725 | 0.963 | -0.400 | -0.771 | 1.389 |
| Q25 | 1241 | 3.821 | 0.978 | -0.489 | -0.737 | 1.402 |
| Q26 | 1243 | 3.891 | 0.930 | -1.160 | 1.535 | 1.559 |
O chunk começa definindo analysis_items como o conjunto de indicadores que será utilizado na AFC e cria item_data a partir da base analítica final, portanto depois da aplicação dos obstáculos e da recodificação dos itens invertidos. Para o diagnóstico de colinearidade, lm() ajusta uma única regressão auxiliar em que ID atua apenas como variável resposta e todos os itens entram como preditores. Como o VIF depende da relação entre os preditores, e não do conteúdo da variável resposta, car::vif() retorna o VIF de cada item em uma única chamada. names() recupera os nomes dos preditores e as.numeric() transforma os valores retornados em uma coluna para a tabela.
Em paralelo, psych::describe() resume cada item com o número de respostas válidas, média, desvio-padrão, assimetria e curtose. as.data.frame(), rownames_to_column() e as_tibble() reorganizam o resultado para que o nome do item passe a ser uma coluna; transmute() seleciona e renomeia somente as estatísticas que serão apresentadas. left_join() combina essa descrição com os VIFs usando Item como chave.
Por fim, write_csv2() salva a tabela completa sem arredondamento. A expressão mutate(across(where(is.numeric), ...)) arredonda apenas a cópia encaminhada ao HTML, e knitr::kable() produz a tabela exibida no documento.
Código
analysis_items <- paste0("Q", 3:26)

item_data <- final_analysis_data |> select(all_of(analysis_items))

vif_model <- lm(ID ~ ., data = final_analysis_data |>
                  select(ID, all_of(analysis_items)),
                na.action = na.omit)
vif_values <- tibble(
  Item = names(car::vif(vif_model)),
  VIF = as.numeric(car::vif(vif_model))
)

item_description <- psych::describe(item_data, fast = FALSE) |>
  as.data.frame() |> rownames_to_column("Item") |> as_tibble() |>
  transmute(
    Item, `Respostas válidas` = n, Média = mean, `Desvio-padrão` = sd,
    Assimetria = skew, Curtose = kurtosis
  )

item_description <- left_join(item_description, vif_values, by = "Item")

write_csv2(
  item_description,
  here::here("Output", "Results", "Tables", "tbl-item-description.csv")
)

item_description |> mutate(across(where(is.numeric), ~ round(.x, 3))) |>
  knitr::kable()
A Tabela 5.4 também permite avaliar a distribuições dos itens. A assimetria é predominantemente negativa, especialmente nos itens com maior concentração nas categorias superiores, enquanto alguns itens apresentam valores de curtose mais elevados. Esses resultados são compatíveis com o padrão esperado para respostas Likert, nas quais a limitação do número de categorias e a concentração das respostas podem produzir desvios da normalidade multivariada. Por essa razão, a estimação subsequente deve utilizar uma abordagem robusta, capaz de ajustar erros-padrão e estatísticas de teste diante de desvios moderados da normalidade (Li, 2016a, 2016b).
A presença de respostas ausentes em alguns itens também deve ser considerada no processo de estimação. Como os participantes não foram excluídos apenas por apresentarem um ou poucos valores ausentes em itens específicos, a análise deve preservar as informações observadas e utilizar o procedimento de máxima verossimilhança com informação completa (Full Information Maximum Likelihood — FIML) (Lai, 2021; Lei & Shiverdecker, 2020). Dessa forma, os valores disponíveis de cada respondente podem contribuir para a estimação sem recorrer à exclusão listwise de todos os casos que apresentem qualquer ausência.
A coluna de VIF complementa a descrição das variáveis ao avaliar possível redundância linear entre os indicadores. Os valores observados permanecem abaixo do limite de referência de 5 (Kyriazos & Poga, 2023), indicando que não há evidência de multicolinearidade severa entre os itens empregados na AFC. Esse resultado é importante porque sugere que a matriz de informação não deve ser comprometida por colinearidade elevada.
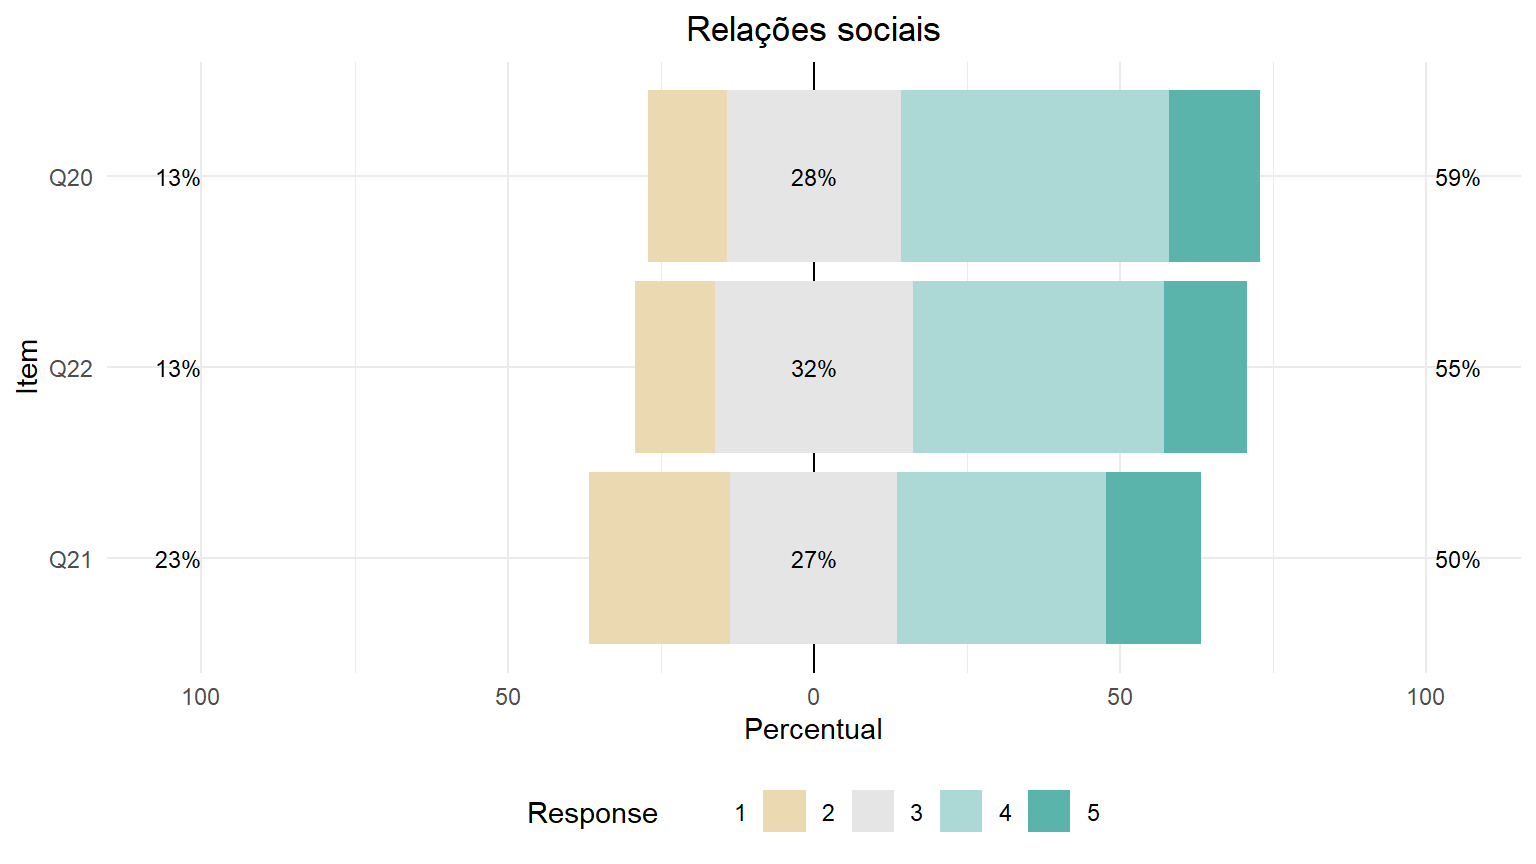
O exemplo reproduzível utiliza o construto Relações sociais, formado pelos itens Q20, Q21 e Q22. As colunas são convertidas em fatores ordenados com cinco níveis possíveis. Essa declaração é necessária porque algumas categorias podem não ter sido observadas na amostra; nlevels = 5 informa ao likert que a escala continua tendo cinco categorias, mesmo quando uma delas apresenta frequência zero.
as.data.frame() fornece à função o tipo de objeto esperado pelo pacote. Em seguida, likert() calcula as frequências relativas e a chamada plot() com centered = TRUE produz as barras divergentes em torno do ponto central. As cores padrão do pacote são mantidas nesta etapa. O resultado recebe apenas os rótulos básicos com ggtitle() e labs() e é exportado como figura PNG por ggsave() para Output/Results/Figures.
Código
social_items <- item_data |>
  select(Q20:Q22) |>
  mutate(across(everything(), ~ factor(
    .x, levels = 1:5, ordered = TRUE
  ))) |>
  as.data.frame()

social_plot <- plot(
  likert::likert(social_items, nlevels = 5),
  centered = TRUE, include.center = TRUE,
  legend.position = "bottom"
) +
  ggtitle("Relações sociais") +
  labs(x = "Item", y = "Percentual", fill = "Resposta") +
  theme_minimal() +
  theme(plot.title = element_text(hjust = 0.5), legend.position = "bottom")
dir.create(here::here("Output", "Results", "Figures"),
           recursive = TRUE, showWarnings = FALSE)
ggsave(
  here::here("Output", "Results", "Figures", "fig-likert-social.png"),
  plot = social_plot, width = 8, height = 4.5, dpi = 300
)
social_plot
A Figura 5.1 apresenta, como exemplo, a distribuição das respostas nos itens do construto Relações sociais. O gráfico permite visualizar simultaneamente a concentração das respostas, a presença de categorias menos utilizadas e a assimetria relativa de cada item. Observa-se maior concentração nas categorias superiores da escala, especialmente nas respostas 4 e 5, padrão coerente com as médias positivas observadas na descrição dos itens.