3 Seleção do modelo de medida
A partir dessa seção, as análises seguem princípios de programação funcional e do Tidyverse Style Guide: funções modulares e reutilizáveis, nomes em snake_case, uso do pipe nativo |> e separação entre computação estatística e apresentação dos resultados. Preservam-se as nomenclaturas dos modelos e as constantes compartilhadas do projeto.
Nas seções seguintes, cada arquivo inicia com um chunk de preparação oculto, que carrega com source() os scripts locais necessários à execução analítica. O script models.R reúne as especificações populacionais e empíricas dos modelos. O script helpers.R carrega os pacotes requeridos e define funções auxiliares e parâmetros compartilhados. Os caminhos são resolvidos por here::here() a partir da raiz do projeto. Os scripts são reutilizáveis, mas sua seleção varia entre as seções: o pré-processamento, por exemplo, utiliza apenas helpers.R, enquanto as etapas com simulação carregam também os utilitários de cache.
O script cache_utils.R define a função cache_or_run(), que reaproveita um objeto da sessão ou seu respectivo arquivo .rds e, quando nenhum deles existe, executa a expressão computacional e salva o resultado. O script cache_loader.R define cache_load_existing(), que lê os arquivos .rds em Data/IntermediateData e disponibiliza os objetos na sessão. Ambos os scripts são carregados nas etapas intensivas para viabilizar o reaproveitamento de rotinas de simulação, operando como um mecanismo independente do cache nativo de chunks do Quarto.
Cada seção instancia os objetos de que necessita, desde que os dados brutos e resultados intermediários estejam disponíveis no repositório. A leitura das bases, a estimação dos modelos e as demais operações específicas constam nos chunks das saídas correspondentes (Racional da saída). No pré-processamento, a geração de determinadas análises possui bloco próprio, pois produz a base analítica empregada nas fases subsequentes.
Os documentos HTML e PDF preservam o rigor do enredo científico. No formato HTML, cada saída (tabela ou figura) é acompanhada de um bloco expansível (Racional da saída) que elucida o encadeamento procedimental: quais operações são executadas e como geram determinado resultado. O conteúdo detalha a finalidade, a preparação requerida, o procedimento técnico e o código executável, indicando o resultado esperado.
Nos blocos de código em HTML, os nomes de funções destacados como links franqueiam acesso à documentação oficial. Ao passar o cursor sobre o identificador, o link direciona para a consulta de sintaxe, argumentos e funcionamento. As rotinas autorais do projeto são explicadas nos callouts e documentadas nos scripts correspondentes. Acima de cada bloco lógico de código, um comentário sucinto em inglês, iniciado por #, resume a operação executada.
Para reproduzir integralmente o trabalho, recomenda-se clonar o repositório do projeto e seguir as orientações metodológicas e de ambiente documentadas no README.
O bloco abaixo exemplifica e executa a rotina de preparação dessa seção:
Utiliza-se como aplicação empírica a escala World Health Organization Quality of Life - Abbreviated Version (WHOQOL-Bref), um instrumento de autorrelato amplamente empregado na mensuração da qualidade de vida em diversas populações e contextos transculturais (Lin & Yao, 2022; Mosqueira Taipe et al., 2026; Skevington & Epton, 2018). O instrumento compreende 26 itens estruturados em cinco categorias de resposta. Os dois primeiros itens mensuram a percepção global da qualidade de vida e a satisfação geral com a saúde; os 24 itens restantes compõem quatro domínios específicos: físico (FIS), psicológico (PSI), relações sociais (SOC) e ambiente (AMB).
A escolha da escala WHOQOL-Bref operacionaliza a diretriz metodológica delineada na Seção 2.1: partir de um instrumento com fundamentação teórica consolidada e evidências psicométricas acumuladas, cujos itens viabilizem o tratamento contínuo das variáveis observadas. A presença de cinco categorias de resposta oferece sustentação empírica inicial a essa estratégia, cujas implicações serão examinadas detalhadamente na descrição dos indicadores (Seção 5.3) e na estimação robusta (Seção 6). O propósito da aplicação consiste em explicitar as decisões de uma AFC e seus fundamentos, preservando o conteúdo dos itens e o formato métrico original do instrumento.
As sínteses da literatura corroboram a estrutura de quatro domínios, indicando simultaneamente que sua aplicação empírica requer atenção às inter-relações entre itens específicos. Lin & Yao (2022) integraram achados de 16 estudos de análise fatorial exploratória e sustentaram a solução de quatro fatores por sua interpretabilidade e parcimônia. Nessa estrutura fatorial, o item Q8 (segurança na vida diária) exibiu carga mais pronunciada no domínio psicológico do que no ambiental, ao qual se vincula teoricamente. Esse resultado evidencia que a sustentação da organização tetrafatorial pode coexistir com complexidades empíricas locais que se afastam de uma estrutura fatorial simples.
A revisão sistemática conduzida por Mosqueira Taipe et al. (2026) amplia essa constatação: a partir de 439 registros mapeados, foram incluídos 36 estudos empíricos, dos quais 64% identificaram a estrutura original de quatro fatores. A revisão respalda a arquitetura conceitual da escala, mas documenta reespecificações associadas a especificidades socioculturais e clínicas, além de expressiva heterogeneidade nos protocolos analíticos e no reporte dos índices de ajuste. Dessa forma, esse conjunto de evidências justifica adotar os quatro domínios teóricos como ponto de partida e prever formalmente as relações residuais e cruzadas a serem avaliadas.
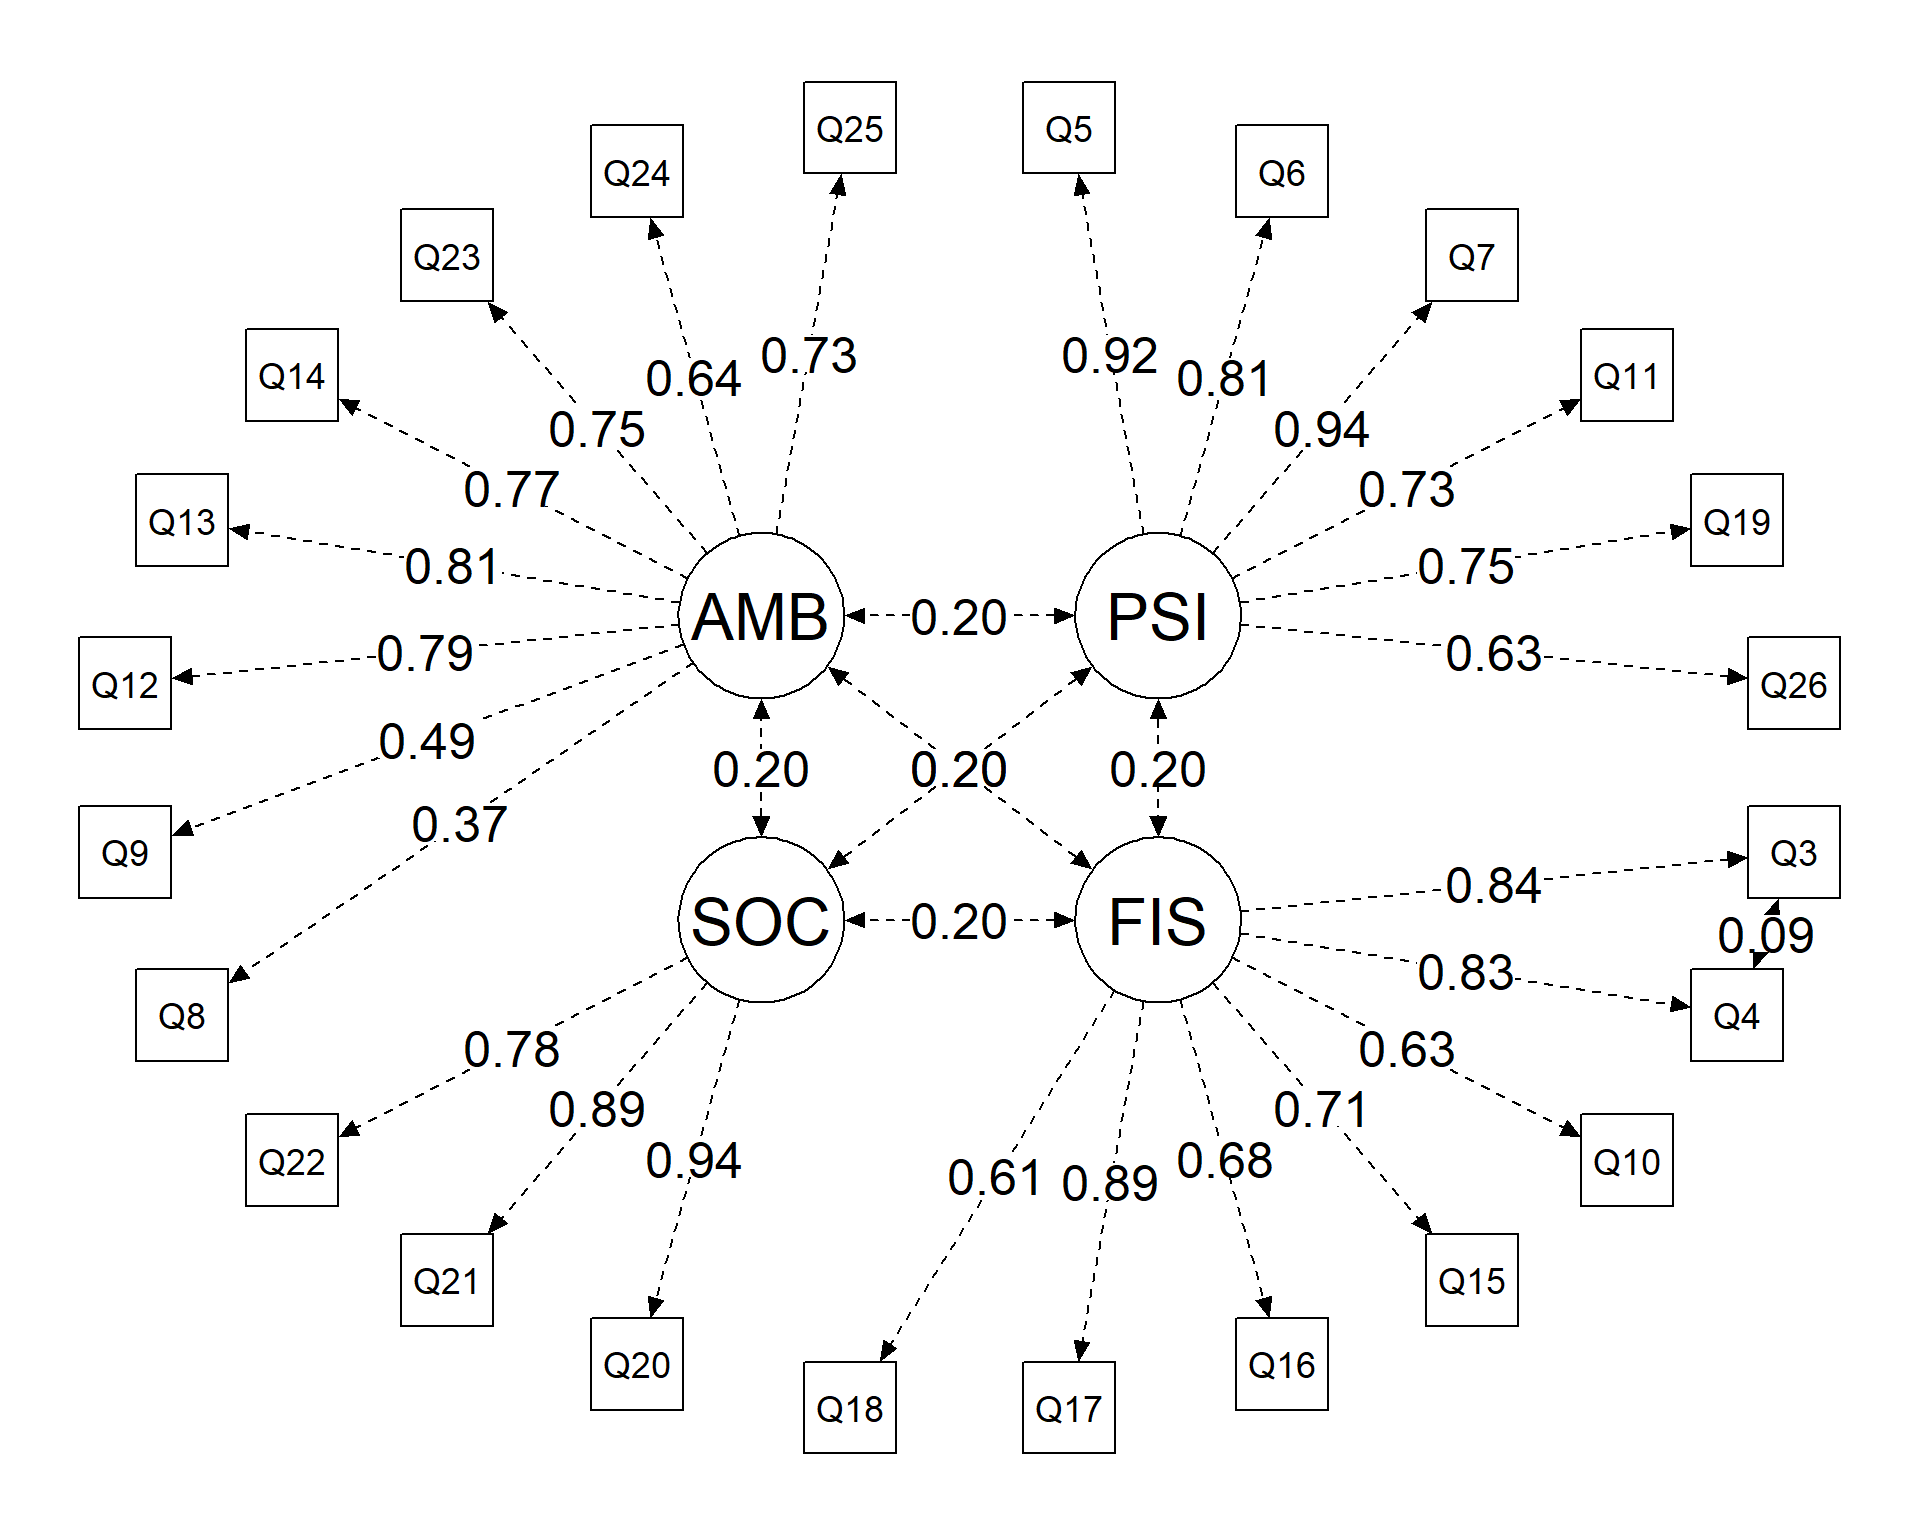
Nesse sentido, a partir dos achados de Lin & Yao (2022), especifica-se o modelo de medida primário (\(H_0\)), que incorpora uma covariância residual entre o item Q3 (dor física e desconforto) e o item Q4 (dependência de tratamento médico) (Figura 3.1). Ambos integram o domínio físico e possuem enunciados direcionados negativamente à qualidade de vida. A sobreposição semântica e a polaridade compartilhada tornam plausível uma associação residual não explicada unicamente pelo fator latente físico. Essa especificação encontra precedentes nos estudos compilados por Mosqueira Taipe et al. (2026). No âmbito do viés de método comum (Common Method Bias, CMB), interpreta-se essa covariância residual como uma hipótese de dependência local decorrente de variância de método compartilhada ou especificidade de conteúdo.
Finalidade
Representar graficamente a especificação populacional de quatro fatores correlacionados, com a covariância residual planejada entre Q3 e Q4. Os valores apresentados correspondem aos parâmetros fixados nessa especificação.
Preparação
Adote a rotina de preparação detalhada em “Como as análises estão organizadas”, no início dessa seção. O script models.R define o modelo popmodel, e o script helpers.R disponibiliza a função gráfica plot_cfa() e o vetor de rótulos LABELS.
Procedimento
A função plot_cfa() recebe a especificação paramétrica no argumento model e compila seu diagrama de caminhos. Internamente, emprega semPlot::semPlotModel() para estruturar o modelo e semPlot::semPaths() para desenhar as relações estruturais. A rotina também aceita objetos de modelos já estimados.
O argumento color = "color" utiliza a paleta automática dos grupos fatoriais. Para gerar o diagrama em escala de cinza e alto contraste, adota-se color = "BW": os vértices são configurados em fundo branco, e os traçados, bordas e legendas permanecem pretos. Essa configuração assegura legibilidade para publicações impressas.
O argumento opcional node_labels = LABELS recorre ao vetor nomeado definido em helpers.R para substituir os identificadores originais psycho, physical, social e environment pelas siglas padronizadas PSI, FIS, SOC e AMB. As substituições operam sobre o nome original de cada vértice, preservando-se rótulos não declarados no vetor. Na ausência desse argumento, a função mantém a nomenclatura original do código-fonte.
Os demais parâmetros mantêm as definições padrão: layout = "circle" organiza a representação fatorial em anel, e what_labels = "est" exibe os valores da especificação informada, correspondentes aos parâmetros populacionais de referência.
Execução e resultado
Após a execução da rotina preparatória, o bloco abaixo gera o diagrama apresentado acima.
Código
# Draw the reference population model.
plot_cfa(popmodel, color = "BW", node_labels = LABELS)
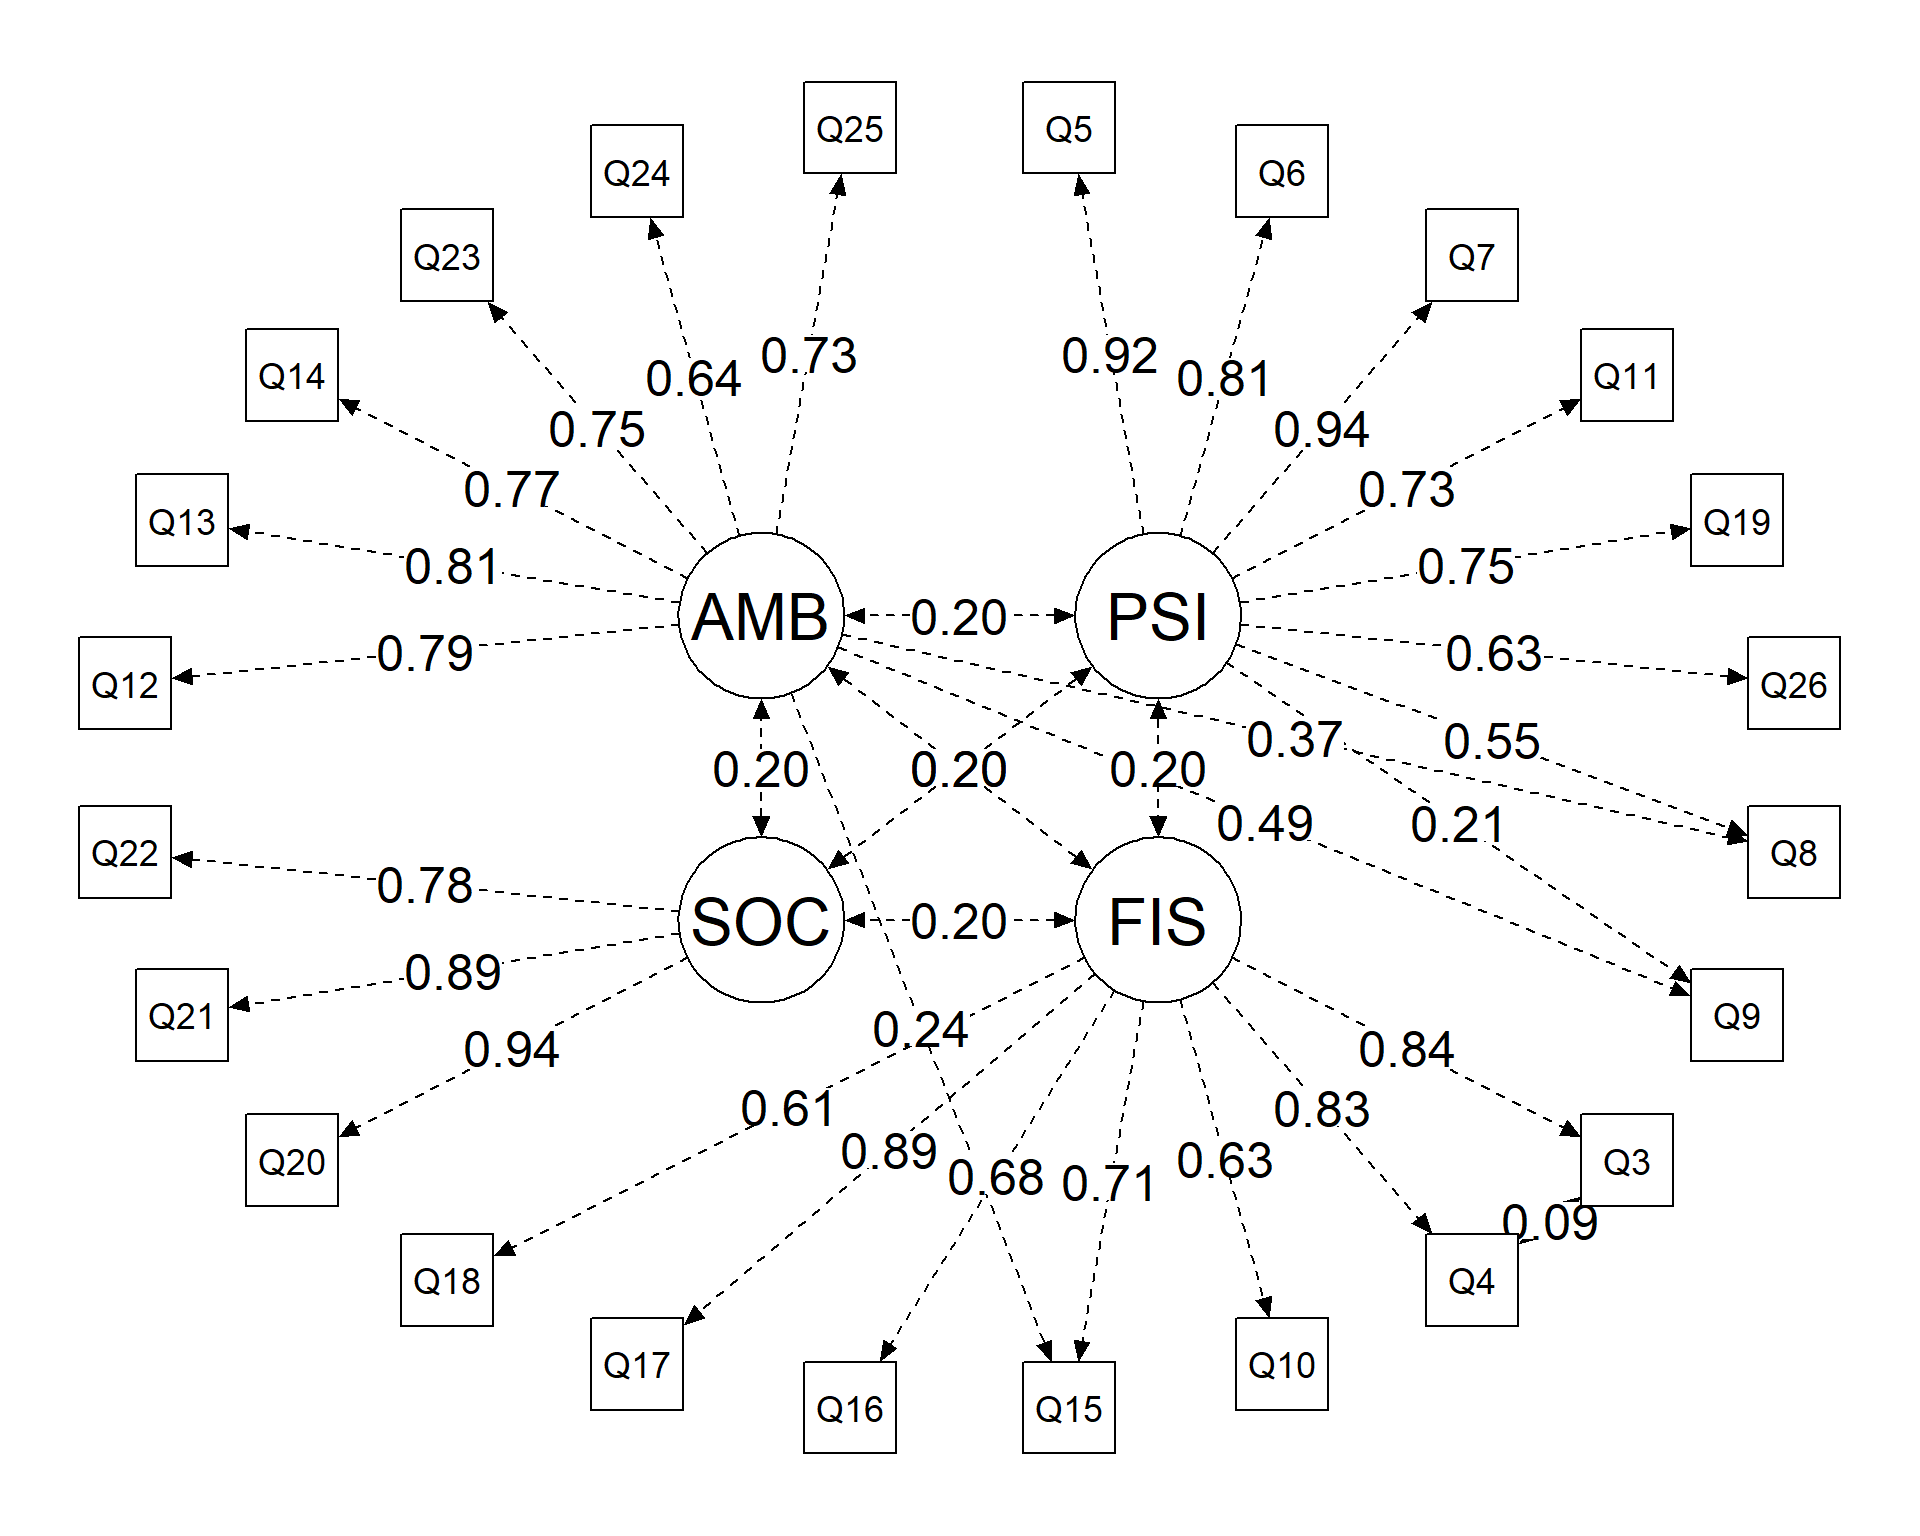
O segundo modelo mantém a covariância residual entre Q3 e Q4 e adiciona três cargas cruzadas: Q8 e Q9 associados ao domínio psicológico e Q15 associado ao domínio ambiental (Figura 3.2). A especificação dessas relações fundamenta-se na solução fatorial exploratória documentada por Lin & Yao (2022). A segurança pessoal percebida em Q8 e as condições do espaço físico em Q9 compartilham conteúdo com o bem-estar psicológico, enquanto a mobilidade funcional aferida por Q15 envolve tanto capacidade física quanto acessibilidade ambiental. Essas interpretações fornecem justificativas teóricas para testar tais parâmetros, constituindo hipóteses a serem confrontadas empiricamente na amostra do presente tutorial.
Mantêm-se as cargas principais de Q8 e Q9 no domínio ambiental e a de Q15 no domínio físico, acrescentando-se as relações propostas em vez de reatribuir os itens de domínio. Tampouco se incorporam todas as cargas secundárias da solução exploratória de Lin & Yao (2022). O modelo alternativo (mal especificado) configura uma especificação delimitada para o presente estudo, apoiada na literatura empírica e na análise semântica dos itens, e não uma AFC previamente validada com essa exata parametrização.
Finalidade
Representar graficamente a especificação populacional alternativa, contendo as três cargas cruzadas planejadas e as cargas principais retidas.
Preparação
Utilize os objetos h1model e LABELS, carregados pela rotina preparatória dessa seção. A função gráfica corresponde à rotina descrita no racional da Figura 3.1.
Procedimento
A instrução substitui popmodel por h1model, incorporando as relações estruturais PSI → Q8, PSI → Q9 e AMB → Q15. Os parâmetros visuais são preservados: os fatores latentes recebem as mesmas abreviações, e os coeficientes numéricos continuam refletindo os valores populacionais fixados.
Execução e resultado
O bloco abaixo executa a instrução que compila o diagrama da especificação alternativa.
Código
# Draw the alternative population model.
plot_cfa(h1model, color = "BW", node_labels = LABELS)