O pré-processamento em questionários de autorrelato tem como finalidade proteger as análises subsequentes contra vieses decorrentes de C/IER, registros incompletos ou respostas inconsistentes, além de inspecionar preliminarmente as variáveis para a detecção precoce de anomalias. Diferentemente das seções anteriores, em que os dados empíricos não foram demandados, as etapas subsequentes operam diretamente sobre dados brutos, adotando-se a mesma base empregada por Rogers (2024) e Rogers (2022).
No presente tutorial, no entanto, o processamento parte dos 1.546 registros brutos e explicita tanto os critérios procedurais (ex-ante) quanto os indicadores estatísticos (ex-post) de triagem C/IER. Como os trabalhos anteriores (Rogers, 2022, 2024) partiram de uma base pré-processada de 1.047 participantes, eventuais diferenças entre seus resultados e os do presente tutorial não devem ser atribuídas exclusivamente ao tratamento ordinal ou contínuo dos itens. Após a verificação da integridade do banco e a remoção de registros sem identificação ou com mais de cinco respostas ausentes na WHOQOL-Bref, a amostra elegível foi submetida a um protocolo sequencial de triagem C/IER. As respostas ausentes nos registros retidos foram preservadas para tratamento via FIML na etapa de estimação.
NotaComo a amostra elegível foi obtida
Finalidade
Preparar os registros brutos e obter a amostra elegível para a triagem de respostas.
Preparação
Utiliza-se Data/InputData/data.csv e a preparação geral da Seção 3. O arquivo deve conter identificação, timestamps, três itens de atenção e os 26 itens da WHOQOL-Bref.
Procedimento
O chunk data-preparation importa o arquivo e define os vetores scale_items e attention_items. A verificação das colunas obrigatórias interrompe a execução se faltar algum campo. O processamento transforma os timestamps em datas, calcula a duração em segundos e converte as respostas em valores numéricos.
A flag dropout identifica registros sem identificação ou com mais de cinco respostas ausentes nos 26 itens. O objeto eligible_data retém os demais registros. O diretório intermediário é preparado antes da gravação. Ao adaptar o processamento, recomenda-se conferir os nomes das colunas e o formato dos timestamps; os critérios de elegibilidade devem corresponder ao protocolo da nova pesquisa.
Execução e resultado
O bloco abaixo executa a preparação e salva whoqol_eligible.csv em Data/IntermediateData. Os objetos criados alimentam os critérios de triagem seguintes.
Código
# Import the raw questionnaire data.raw_data<-read_csv2(here::here("Data", "InputData", "data.csv"), show_col_types =FALSE)# Identify the scale items and attention checks.scale_items<-paste0("Q", 1:26)attention_items<-paste0("CQ", 1:3)# Check that all required columns are available.required_columns<-c("ID", "CREATED", "MODIFIED", attention_items, scale_items)missing_columns<-setdiff(required_columns, names(raw_data))if(length(missing_columns)>0){cli::cli_abort("As colunas obrigatórias ausentes são: {paste(missing_columns, collapse = ', ')}")}# Flag incomplete records and prepare response values and durations.prepared_data<-raw_data|>mutate( dropout =is.na(ID)|rowSums(is.na(pick(all_of(scale_items))))>5, created_dt =as.POSIXct(CREATED, format ="%d/%m/%Y %H:%M", tz ="UTC"), modified_dt =as.POSIXct(MODIFIED, format ="%d/%m/%Y %H:%M", tz ="UTC"), TIME =as.numeric(difftime(modified_dt, created_dt, units ="secs")),across(all_of(c(attention_items, scale_items)), as.numeric))# Retain the records eligible for response screening.eligible_data<-prepared_data|>filter(!dropout)# Create the output directory if it is missing.dir.create(here::here("Data", "IntermediateData"), showWarnings =FALSE)# Save the eligible sample.write_csv2(eligible_data,here::here("Data", "IntermediateData", "whoqol_eligible.csv"))
Para o tratamento dos indivíduos com C/IER adotou-se a abordagem de múltiplos obstáculos (multiple-hurdle approach) recomendada por Curran (2016) e DeSimone et al. (2015). Como os índices de desatenção mensuram manifestações comportamentais distintas (a exemplo de respostas aleatórias, padrões invariantes e preenchimento excessivamente rápido) e podem apresentar correlações baixas ou nulas entre si (Biemann et al., 2025; Goldammer et al., 2020; Meade & Craig, 2012), a literatura preconiza a aplicação combinada de múltiplos critérios de triagem (Arthur et al., 2021; Curran, 2016; Ulitzsch et al., 2022). No presente tutorial, cada critério foi tratado como uma barreira obrigatória, de modo que a falha em qualquer obstáculo determinou a exclusão do participante da amostra final (Curran, 2016; Goldammer et al., 2020).
5.1 Exclusões procedurais
No âmbito dos controles ex-ante, adotaram-se itens de atenção inseridos no questionário e a duração total de preenchimento da pesquisa (Curran, 2016; Ward & Meade, 2023). A falha em pelo menos dois dos três itens de atenção incluídos foi interpretada como evidência de C/IER (Chauliac et al., 2023; DeSimone et al., 2015). Adicionalmente, foram excluídos os questionários de respondentes com velocidade inferior a quatro segundos por item, limiar adotado para sinalizar preenchimentos excessivamente rápidos nessa aplicação, situando-se dentro do intervalo de referência de dois a quatro segundos por item discutido na Seção 2.3.
NotaOperacionalização dos itens de atenção e tempo
Finalidade
Identificar falhas nos controles de atenção e no tempo de preenchimento.
Preparação
Utilizam-se eligible_data, attention_items e scale_items, criados no bloco de obtenção da amostra elegível.
Procedimento
O processamento seleciona identificação, controles, duração e itens. Conta as respostas diferentes de 1 nos controles e cria fail_attention quando há pelo menos duas falhas. A flag fail_time identifica TIME < 416, correspondente ao critério de quatro segundos por item para o questionário completo de 104 itens. Esses critérios pertencem ao protocolo dessa aplicação e devem ser revistos em eventuais adaptações da rotina.
Execução e resultado
Execute o bloco para criar procedural_data e salvar whoqol_procedural.csv em Data/IntermediateData.
Código
# Flag failures in attention checks and response time.procedural_data<-eligible_data|>select(ID, all_of(attention_items), TIME, all_of(scale_items))|>mutate( qc_failures =rowSums(across(all_of(attention_items), ~.x!=1), na.rm =TRUE), fail_attention =qc_failures>=2, fail_time =TIME<416)# Save the procedural screening results.write_csv2(procedural_data,here::here("Data", "IntermediateData", "whoqol_procedural.csv"))
5.2 Critérios estatísticos
Como critérios ex-post, empregaram-se a medida de longstring, o IRV e a distância de Mahalanobis (Biemann et al., 2025; Dunn et al., 2018). O primeiro indicador permite identificar padrões mecânicos de marcação uniforme, o segundo detecta tanto variabilidade anormalmente baixa quanto dispersão atipicamente elevada, e o terceiro aponta padrões multivariados distantes do comportamento normativo da amostra, condizentes com aleatoriedade excessiva (Curran, 2016; DeSimone et al., 2015; Hong et al., 2020; Meade & Craig, 2012). Considerou-se problemática uma sequência contínua (longstring) superior a 13 respostas consecutivas, o que corresponde à metade dos 26 itens da WHOQOL-Bref avaliados na triagem. Para o IRV, adotaram-se os percentis 1% e 99%, enquanto para a distância de Mahalanobis estabeleceu-se o percentil 99%. As regras de triagem foram delimitadas com base na extensão da escala e nas caudas das distribuições empíricas. Os pontos de corte foram calculados diretamente sobre a amostra submetida aos critérios estatísticos, buscando equilibrar a sensibilidade à desatenção e a preservação de respondentes sinceros (Arthur et al., 2021; Goldammer et al., 2020; Steedle, 2018).
NotaCálculo dos índices estatísticos
Finalidade
Calcular os indicadores estatísticos de triagem e sinalizar os registros que atingem os critérios de exclusão.
Preparação
Utilizam-se procedural_data e scale_items. Os indicadores são calculados antes da recodificação dos itens invertidos.
Procedimento
O bloco acrescenta Longstring, IRV e distância de Mahalanobis. Para a distância, calcula médias por item e covariâncias baseadas nos pares observados. Em seguida, extrai os percentis amostrais e cria três flags: Longstring maior que 13, IRV nas caudas de 1% ou 99% e distância de Mahalanobis a partir do percentil 99.
O objeto screened_data reúne os indicadores e as flags procedurais e estatísticas. A exportação preserva esses indicadores para auditoria; a tabela seguinte resume os limites utilizados.
Execução e resultado
Execute o bloco para criar indicator_data, os limites amostrais e screened_data, e salvar whoqol_indicators.csv em Data/IntermediateData.
Código
# Calculate longstring, response variability, and Mahalanobis distance.indicator_data<-procedural_data|>mutate( longstring =as.integer(careless::longstring(pick(all_of(scale_items)))), irv =as.numeric(careless::irv(pick(all_of(scale_items)), split =FALSE)), mahalanobis =as.numeric(modi::MDmiss( data =as.matrix(pick(all_of(scale_items))), center =colMeans(pick(all_of(scale_items)), na.rm =TRUE), cov =cov(pick(all_of(scale_items)), use ="pairwise.complete.obs"))))# Define the empirical cutoffs for variability and Mahalanobis distance.irv_cutoffs<-quantile(indicator_data$irv, probs =c(.01, .99), na.rm =TRUE, names =FALSE, type =7)mahalanobis_cutoff<-quantile(indicator_data$mahalanobis, probs =.99, na.rm =TRUE, names =FALSE, type =7)# Apply the response-screening rules.screened_data<-indicator_data|>mutate( fail_longstring =longstring>13, fail_irv =irv<=irv_cutoffs[[1]]|irv>=irv_cutoffs[[2]], fail_mahalanobis =mahalanobis>=mahalanobis_cutoff)# Save the statistical screening indicators.write_csv2(screened_data|>select(ID, longstring, irv, mahalanobis, fail_longstring,fail_irv, fail_mahalanobis),here::here("Data", "IntermediateData", "whoqol_indicators.csv"))
Tabela 5.1: Pontos de corte dos indicadores estatísticos.
Sintetizar as distribuições dos três indicadores estatísticos e registrar as regras de exclusão utilizadas na triagem.
Preparação
Utilizam-se os indicadores de indicator_data e os limites irv_cutoffs e mahalanobis_cutoff, calculados no bloco anterior.
Procedimento
O bloco organiza tendência central, dispersão e percentis em indicator_cutoffs, ao lado da regra de exclusão de cada indicador. A tabela documenta os critérios já definidos. Os valores completos são salvos antes do arredondamento da cópia de apresentação para três casas decimais.
Execução e resultado
Execute o bloco para apresentar a síntese e salvar tbl-indicator-cutoffs.csv em Output/Results/Tables.
Código
# Summarize the statistical screening cutoffs.indicator_cutoffs<-tibble( Indicador =c("Longstring", "IRV", "Distância de Mahalanobis"), Média =c(mean(indicator_data$longstring, na.rm =TRUE),mean(indicator_data$irv, na.rm =TRUE),mean(indicator_data$mahalanobis, na.rm =TRUE)), `Desvio-padrão` =c(sd(indicator_data$longstring, na.rm =TRUE),sd(indicator_data$irv, na.rm =TRUE),sd(indicator_data$mahalanobis, na.rm =TRUE)), Mediana =c(median(indicator_data$longstring, na.rm =TRUE),median(indicator_data$irv, na.rm =TRUE),median(indicator_data$mahalanobis, na.rm =TRUE)), `1º percentil` =c(quantile(indicator_data$longstring, .01, na.rm =TRUE),irv_cutoffs[[1]],quantile(indicator_data$mahalanobis, .01, na.rm =TRUE)), `99º percentil` =c(quantile(indicator_data$longstring, .99, na.rm =TRUE),irv_cutoffs[[2]], mahalanobis_cutoff), `Regra de exclusão` =c("longstring > 13","IRV ≤ p1 ou IRV ≥ p99","Mahalanobis ≥ p99"))# Create the results directory if it is missing.dir.create(here::here("Output", "Results", "Tables"), recursive =TRUE, showWarnings =FALSE)# Save the screening cutoffs.write_csv2(indicator_cutoffs,here::here("Output", "Results", "Tables", "tbl-indicator-cutoffs.csv"))# Present the screening cutoffs with three decimal places.indicator_cutoffs|>mutate(across(where(is.numeric), ~round(.x, 3)))|>knitr::kable()
5.2.1 Decisão final e amostra de análise
Após o cálculo dos indicadores de atenção, velocidade, invariância e discrepância multivariada, cada participante foi avaliado simultaneamente nos cinco obstáculos definidos no protocolo. A decisão de exclusão foi aplicada de forma estrita: a falha em qualquer barreira determinou a exclusão do respondente da amostra de análise. A Tabela 5.2 resume a frequência de sinalização em cada critério e permite avaliar quais manifestações de resposta descuidada foram mais frequentes na amostra elegível. As sinalizações associadas aos itens de atenção e ao IRV foram as mais recorrentes, ao passo que o tempo de resposta apresentou menor incidência. Essa distribuição reforça a utilidade da estratégia de múltiplos obstáculos, pois os critérios não identificam exatamente os mesmos participantes nem representam uma única modalidade de resposta inadequada.
Tabela 5.2: Frequência de falhas em cada obstáculo de limpeza.
Aplicar a decisão conjunta de triagem e resumir as falhas em cada um dos cinco critérios.
Preparação
Utiliza-se screened_data, que reúne os indicadores e as flags dos controles procedurais e estatísticos.
Procedimento
O bloco conta as flags de falha por participante e define exclude = hurdles_failed > 0: qualquer obstáculo falhado determina a exclusão. A operação por linha com pmap_chr() reúne os critérios sinalizados em evidence, preservando a justificativa individual.
O objeto intermediate_data guarda os registros com indicadores e decisões, enquanto criterion_summary resume as frequências e os percentuais sobre a amostra elegível. Como um participante pode falhar em múltiplos critérios simultaneamente, essas frequências não constituem grupos mutuamente exclusivos. O arredondamento afeta unicamente a exibição da tabela.
Execução e resultado
Execute o bloco para apresentar o resumo e salvar whoqol_preprocessed.csv em Data/IntermediateData, exclusion_log.csv em Output/DataAppendixOutput/Tables e tbl-hurdle-summary.csv em Output/Results/Tables.
Código
# Apply the response-screening rules.screened_data<-screened_data|>mutate( hurdles_failed =rowSums(across(starts_with("fail_"))), exclude =hurdles_failed>0, evidence =pmap_chr(pick(fail_attention, fail_time, fail_longstring,fail_irv, fail_mahalanobis), \(...){labels<-c("atenção", "tempo", "longstring", "IRV", "Mahalanobis")str_c(labels[c(...)], collapse =" + ")|>na_if("")}))# Preserve the screening data and summarize failures by criterion.intermediate_data<-screened_datacriterion_summary<-tibble( Critério =c("Itens de atenção", "Tempo de resposta", "Longstring", "IRV","Distância de Mahalanobis"), `N sinalizado` =c(sum(screened_data$fail_attention), sum(screened_data$fail_time),sum(screened_data$fail_longstring), sum(screened_data$fail_irv),sum(screened_data$fail_mahalanobis)))|>mutate(`Percentual (%)` =`N sinalizado`/nrow(screened_data)*100)# Create the output directory if it is missing.dir.create(here::here("Data", "IntermediateData"), showWarnings =FALSE)# Create the output directory if it is missing.dir.create(here::here("Output", "DataAppendixOutput", "Tables"), recursive =TRUE, showWarnings =FALSE)# Save the complete preprocessing data.write_csv2(intermediate_data, here::here("Data", "IntermediateData", "whoqol_preprocessed.csv"))# Save the respondent exclusion log.write_csv2(intermediate_data|>filter(exclude), here::here("Output", "DataAppendixOutput", "Tables", "exclusion_log.csv"))# Present the frequency of screening failures.criterion_summary|>mutate(`Percentual (%)` =round(`Percentual (%)`, 1))|>knitr::kable()# Save the screening failure summary.write_csv2(criterion_summary,here::here("Output", "Results", "Tables", "tbl-hurdle-summary.csv"))
A aplicação conjunta dos cinco obstáculos resultou em redução amostral de 1.546 para 1.243 participantes. Dos 1.546 registros brutos, 223 foram eliminados na etapa preliminar por não apresentarem as condições mínimas de preenchimento da escala. Entre os 1.323 respondentes elegíveis aos obstáculos, 80 falharam em pelo menos um critério e foram excluídos da base analítica. Essa trajetória evidencia que a maior perda amostral ocorreu antes da aplicação dos indicadores de C/IER, ao passo que a triagem comportamental produziu uma exclusão proporcionalmente menor, concentrada em padrões incompatíveis com o preenchimento atencioso. A Tabela 5.3 sintetiza essa evolução.
Tabela 5.3: Trajetória da amostra durante o pré-processamento.
Obter a base de análise final e documentar a trajetória de seleção da amostra.
Preparação
Utilizam-se screened_data com a decisão exclude criada no bloco anterior, os itens identificados em scale_items e os objetos que registram as etapas precedentes.
Procedimento
O processamento retém os respondentes aprovados em todos os obstáculos, seleciona identificação e itens, e recodifica os itens com polaridade invertida. A tabela sample_summary reúne as contagens desde os registros brutos até a amostra final. As verificações asseguram a correspondência entre a regra de exclusão e o número de linhas, além da ausência de identificadores nulos. Ao adaptar a rotina, recomenda-se conferir a polaridade e a escala de resposta dos itens antes de reutilizar a recodificação.
Execução e resultado
Execute o bloco para criar final_analysis_data, salvar Data/AnalysisData/whoqol_analysis.csv e apresentar e exportar a trajetória em Output/Results/Tables/tbl-analysis-sample-summary.csv.
Código
# Retain eligible respondents and reverse-score the negative items.final_analysis_data<-screened_data|>filter(!exclude)|>select(ID, all_of(scale_items))|>mutate(across(all_of(c("Q3", "Q4", "Q26")), ~6-.x))# Summarize the sample size at each preprocessing stage.sample_summary<-tibble( Etapa =c("Banco bruto", "Dropouts removidos", "Elegíveis aos obstáculos","Excluídos por pelo menos um obstáculo", "Amostra analítica final"), N =c(nrow(raw_data), sum(prepared_data$dropout), nrow(indicator_data),sum(intermediate_data$exclude), nrow(final_analysis_data)))# Create the output directory if it is missing.dir.create(here::here("Data", "AnalysisData"), showWarnings =FALSE)# Save the final analysis data.write_csv2(final_analysis_data, here::here("Data", "AnalysisData", "whoqol_analysis.csv"))# Check the final sample size and respondent identifiers.stopifnot(nrow(final_analysis_data)==sum(!intermediate_data$exclude),!anyNA(final_analysis_data$ID))# Present the sample-selection summary.sample_summary|>knitr::kable()# Save the sample-selection summary.write_csv2(sample_summary,here::here("Output", "Results", "Tables", "tbl-analysis-sample-summary.csv"))
5.3 Descrição dos itens
Com a amostra de análise delimitada, a etapa seguinte consistiu em avaliar o comportamento empírico dos itens que integram o modelo de AFC. Essa inspeção preliminar verifica o volume de respostas disponíveis, a tendência central, a dispersão e o formato das distribuições, fornecendo subsídios diretos para a escolha do estimador psicométrico. Em termos gerais, os itens apresentaram médias superiores ao ponto médio da escala e variabilidade adequada para capturar as diferenças individuais. A proporção de dados ausentes variou discretamente entre os itens, mantendo-se em níveis residuais e justificando a retenção dos participantes mediante tratamento por FIML. A Tabela 5.4 sintetiza essas estatísticas.
Tabela 5.4: Estatísticas descritivas dos itens utilizados na AFC.
Descrever os indicadores da AFC e reunir o diagnóstico de colinearidade na mesma tabela.
Preparação
Utiliza-se final_analysis_data, já submetida à triagem e à recodificação. Os indicadores da análise compreendem os itens Q3 a Q26.
Procedimento
O bloco cria item_data e calcula contagem de respostas válidas, média, desvio-padrão, assimetria e curtose. Uma regressão auxiliar usa os itens como preditores e ID como variável dependente apenas para extrair os respectivos VIFs: esse diagnóstico decorre exclusivamente das inter-relações lineares entre os preditores.
As estatísticas descritivas e os VIFs são combinados pelo rótulo do item em item_description. A gravação preserva os valores originais; a exibição arredonda os dados para três casas decimais.
Execução e resultado
Execute o bloco para criar item_data, apresentar a tabela e salvar tbl-item-description.csv em Output/Results/Tables. O objeto item_data também será utilizado no gráfico subsequente.
Código
# Identify the indicators used in the factor analysis.analysis_items<-paste0("Q", 3:26)# Select the analysis items.item_data<-final_analysis_data|>select(all_of(analysis_items))# Estimate an auxiliary regression and extract item VIFs.vif_model<-lm(ID~., data =final_analysis_data|>select(ID, all_of(analysis_items)), na.action =na.omit)vif_values<-tibble( Item =names(car::vif(vif_model)), VIF =as.numeric(car::vif(vif_model)))# Calculate the descriptive statistics for each item.item_description<-psych::describe(item_data, fast =FALSE)|>as.data.frame()|>rownames_to_column("Item")|>as_tibble()|>transmute(Item, `Respostas válidas` =n, Média =mean, `Desvio-padrão` =sd, Assimetria =skew, Curtose =kurtosis)# Combine item descriptions and collinearity diagnostics.item_description<-left_join(item_description, vif_values, by ="Item")# Save the item statistics before display rounding.write_csv2(item_description,here::here("Output", "Results", "Tables", "tbl-item-description.csv"))# Present the item statistics with three decimal places.item_description|>mutate(across(where(is.numeric), ~round(.x, 3)))|>knitr::kable()
A Tabela 5.4 permite também avaliar a distribuição dos itens. Observa-se assimetria predominantemente negativa, sobretudo nos itens com maior concentração nas categorias superiores, ao passo que determinados itens exibem coeficientes de curtose mais elevados. Esses achados são compatíveis com o padrão característico de respostas em escalas Likert, nas quais a amplitude discreta de categorias e a assimetria das respostas produzem afastamentos em relação à normalidade multivariada. Por essa razão, a estimação subsequente requer procedimentos dotados de correções robustas para os erros-padrão e para as estatísticas de teste (Li, 2016a, 2016b).
A presença de dados ausentes residuais em determinados itens igualmente orienta a escolha metodológica. Como os participantes não foram descartados por omissões pontuais, a análise preserva a integralidade das informações observadas ao empregar o procedimento FIML (Lai, 2021; Lei & Shiverdecker, 2020). Dessa forma, as respostas disponíveis de cada participante contribuem para a função de verossimilhança sem necessidade de exclusão listwise.
Os valores de VIF complementam a inspeção univariada ao rastrear eventuais redundâncias lineares severas entre os indicadores. Todas as estimativas situaram-se confortavelmente abaixo do ponto de corte de 5 (Kyriazos & Poga, 2023), assegurando a ausência de multicolinearidade crítica entre os itens da AFC e garantindo a estabilidade numérica na inversão das matrizes de covariâncias e de informação.
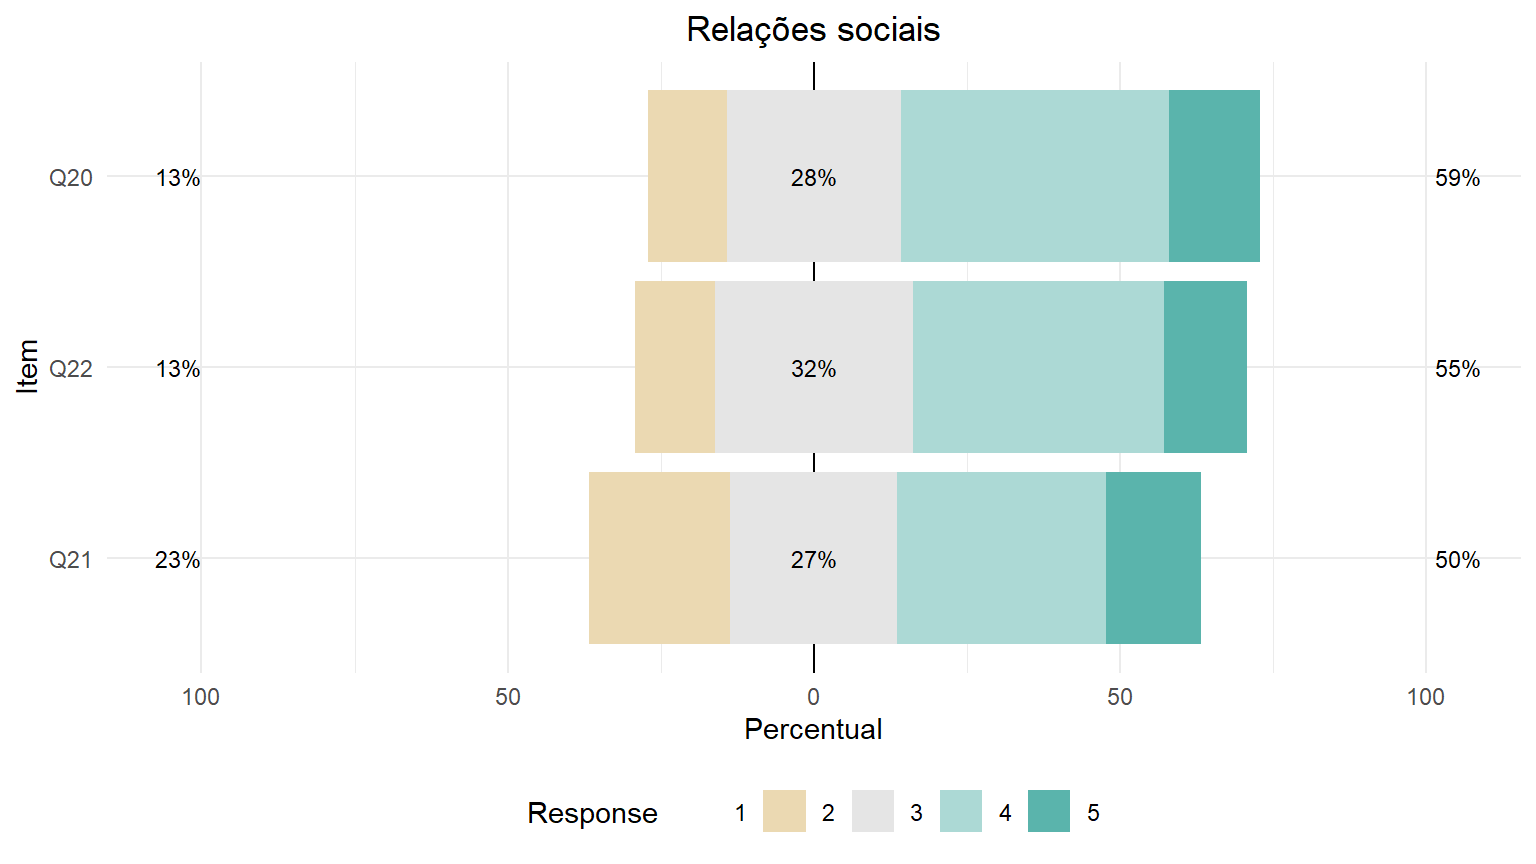
Como exemplo, a Figura 5.1 ilustra a distribuição empírica das respostas nos itens do construto Relações Sociais. O gráfico evidencia simultaneamente a concentração das marcações, a baixa frequência nas categorias inferiores e a assimetria de cada indicador. Observa-se maior adensamento nas categorias 4 e 5 da escala, padrão plenamente condizente com as médias elevadas reportadas na Tabela 5.4.
Figura 5.1: Distribuição das categorias de resposta Likert no construto Relações sociais.
Visualizar as frequências das categorias de resposta nos três itens de Relações sociais.
Preparação
Utiliza-se item_data, criada na descrição dos indicadores, selecionando-se os itens Q20, Q21 e Q22.
Procedimento
As respostas são convertidas em fatores ordenados com cinco níveis possíveis, preservando também categorias sem observações. O argumento nlevels = 5 mantém essa estrutura na preparação com likert(). O desenho com centered = TRUE organiza barras divergentes em torno do ponto central. A apresentação mantém as cores padrão e acrescenta título e rótulos básicos.
Execução e resultado
Execute o bloco para criar e apresentar social_plot e salvar fig-likert-social.png em Output/Results/Figures.
Código
# Prepare the social-domain items as five-category factors.social_items<-item_data|>select(Q20:Q22)|>mutate(across(everything(), ~factor(.x, levels =1:5, ordered =TRUE)))|>as.data.frame()# Plot the response distributions for the social-domain items.social_plot<-plot(likert::likert(social_items, nlevels =5), centered =TRUE, include.center =TRUE, legend.position ="bottom")+ggtitle("Relações sociais")+labs(x ="Item", y ="Percentual", fill ="Resposta")+theme_minimal()+theme(plot.title =element_text(hjust =0.5), legend.position ="bottom")dir.create(here::here("Output", "Results", "Figures"), recursive =TRUE, showWarnings =FALSE)ggsave(here::here("Output", "Results", "Figures", "fig-likert-social.png"), plot =social_plot, width =8, height =4.5, dpi =300)social_plot
Biemann, T., Koch-Bayram, I. F., Meier-Barthold, M., & Aguinis, H. (2025). Using Markov Chains to Detect Careless Responding in Survey Research. Organ. Res. Methods, 28(4), 543–568. https://doi.org/10.1177/10944281251334778
Chauliac, M., Willems, J., Gijbels, D., & Donche, V. (2023). The Prevalence of Careless Response Behaviour and Its Consequences on Data Quality in Self-Report Questionnaires on Student Learning. Front. Educ., 8. https://doi.org/10.3389/feduc.2023.1197324
Curran, P. G. (2016). Methods for the Detection of Carelessly Invalid Responses in Survey Data. J. Exp. Soc. Psychol., 66, 4–19. https://doi.org/10.1016/j.jesp.2015.07.006
DeSimone, J. A., Harms, P. D., & DeSimone, A. J. (2015). Best Practice Recommendations for Data Screening. J. Organ. Behav., 36(2), 171–181. https://doi.org/10.1002/job.1962
Dunn, A. M., Heggestad, E. D., Shanock, L. R., & Theilgard, N. (2018). Intra-Individual Response Variability as an Indicator of Insufficient Effort Responding: Comparison to Other Indicators and Relationships with Individual Differences. J. Bus. Psychol., 33(1), 105–121. https://doi.org/10.1007/s10869-016-9479-0
Goldammer, P., Annen, H., Stöckli, P. L., & Jonas, K. (2020). Careless Responding in Questionnaire Measures: Detection, Impact, and Remedies. Leadersh. Q., 31(4), 101384. https://doi.org/10.1016/j.leaqua.2020.101384
Hong, M., Steedle, J. T., & Cheng, Y. (2020). Methods of Detecting Insufficient Effort Responding: Comparisons and Practical Recommendations. Educ. Psychol. Meas., 80(2), 312–345. https://doi.org/10.1177/0013164419865316
Kyriazos, T., & Poga, M. (2023). Dealing with Multicollinearity in Factor Analysis: The Problem, Detections, and Solutions. Open Journal of Statistics, 13(3), 404–424. https://doi.org/10.4236/ojs.2023.133020
Lai, K. (2021). Using Information Criteria Under Missing Data: Full Information Maximum Likelihood Versus Two-Stage Estimation. Structural Equation Modeling: A Multidisciplinary Journal, 28(2), 278–291. https://doi.org/10.1080/10705511.2020.1780925
Lei, P.-W., & Shiverdecker, L. K. (2020). Performance of Estimators for Confirmatory Factor Analysis of Ordinal Variables with Missing Data. Structural Equation Modeling: A Multidisciplinary Journal, 27(4), 584–601. https://doi.org/10.1080/10705511.2019.1680292
Li, C. H. (2016a). Confirmatory Factor Analysis with Ordinal Data: Comparing Robust Maximum Likelihood and Diagonally Weighted Least Squares. Behavior Research Methods, 48(3), 936–949. https://doi.org/10.3758/s13428-015-0619-7
Li, C. H. (2016b). The Performance of ML, DWLS, and ULS Estimation with Robust Corrections in Structural Equation Models with Ordinal Variables. Psychological Methods, 21(3), 369–387. https://doi.org/10.1037/met0000093
Meade, A. W., & Craig, S. B. (2012). Identifying Careless Responses in Survey Data. Psychol. Methods, 17(3), 437–455. https://doi.org/10.1037/a0028085
Rogers, P. (2024). Best Practices for Your Confirmatory Factor Analysis: A JASP and Lavaan Tutorial. Behavior Research Methods. https://doi.org/10.3758/s13428-024-02375-7
Steedle, J. (2018). Detecting Inattentive Responding on a Psychosocial Measure of College Readiness. ACT.org.
Ulitzsch, E., Pohl, S., Khorramdel, L., Kroehne, U., & Davier, M. von. (2022). A Response-Time-Based Latent Response Mixture Model for Identifying and Modeling Careless and Insufficient Effort Responding in Survey Data. Psychometrika, 87(2), 593–619. https://doi.org/10.1007/s11336-021-09817-7
Ward, M. K., & Meade, A. W. (2023). Dealing with Careless Responding in Survey Data: Prevention, Identification, and Recommended Best Practices. Annu. Rev. Psychol., 74(Volume 74, 2023), 577–596. https://doi.org/10.1146/annurev-psych-040422-045007