| Medida | H0 | H1 |
|---|---|---|
| N | 621 | 621 |
| χ² ajust. | 764.651 | 712.025 |
| df | 245 | 242 |
| p-valor | < 0.001 | < 0.001 |
| CFI (robusto) | 0.895 | 0.905 |
| TLI (robusto) | 0.882 | 0.892 |
| RMSEA (robusto) | 0.063 | 0.060 |
| RMSEA IC90% inf. | 0.058 | 0.055 |
| RMSEA IC90% sup. | 0.068 | 0.066 |
| p (RMSEA ≤ 0,05) | < 0.001 | < 0.001 |
| SRMR | 0.054 | 0.050 |
7 Ajuste do modelo
7.1 Ajuste global dos modelos originais
O ajuste global avalia a extensão em que a estrutura de covariâncias dos indicadores é reproduzida pelas relações especificadas no modelo. Conforme fundamentado na Seção 2.5, essa avaliação articula o teste de ajuste exato a índices descritivos que quantificam a magnitude do desajuste residual.
A Tabela 7.1 apresenta os resultados de H0 e H1 estimados para os 621 participantes da subamostra de calibração. O teste \(\chi^2\) e o respectivo \(p\)-valor reportam a estatística com correção de escala (Satorra-Bentler), ao passo que CFI, TLI e RMSEA são informados em suas versões robustas, incluindo os limites do intervalo de confiança de 90% do RMSEA. O SRMR complementa o diagnóstico como medida de desajuste médio absoluto nas correlações. A leitura conjunta e integrada desses índices orienta o julgamento confirmatório das especificações originais (Mai et al., 2021; Niemand & Mai, 2018).
NotaRacional da Tabela 7.1
Finalidade
Reunir as medidas de ajuste global de H0 e H1 para apresentação comparativa lado a lado.
Preparação
Utilizam-se a base Data/AnalysisData/whoqol_cv.csv, salva na Seção 6, as especificações analyzemodel e h1modelfree e a rotina geral da Seção 3. O código lê a partição salva e seleciona sample_group == 0 em calibration_data, recuperando a subamostra de calibração sem demandar novo sorteio ou depender do estado da sessão anterior.
Procedimento
O bloco lê a partição persistida e estima os dois modelos na subamostra de calibração, mantendo as condições da Seção 6. A função table_fit(), definida em helpers.R, recebe cada ajuste e consolida as estatísticas de ajuste. A rotina auxiliar tidy_fit() organiza os índices compatíveis com o estimador empregado, preservando os valores numéricos em precisão completa.
O atributo fit_data fornece as medidas completas para inserção inline no texto, enquanto table_data estrutura os dados para exibição. Após verificar a disponibilidade de ambas as tabelas, o bloco as combina por medida, dedicando uma coluna a cada modelo.
Execução e resultado
Execute o bloco para processar os ajustes, gerar fit_global e salvar tbl-model-fit-global.csv em Output/Results/Tables. As estimativas serão aproveitadas nas saídas seguintes.
Código
# Read the saved partition created in Section 6.
cv_data <- readr::read_csv2(
  here::here("Data", "AnalysisData", "whoqol_cv.csv"),
  na = c("", "NA"),
  col_types = readr::cols(
    ID = readr::col_character(),
    missing_flag = readr::col_integer(),
    sample_group = readr::col_integer()
  ),
  show_col_types = FALSE
)

# Select the same calibration sample used for parameter estimation.
calibration_data <- cv_data[cv_data$sample_group == 0L, ]

# Recreate the H0 fit using the same settings as in Section 6.
fit_analyzemodel <- lavaan::cfa(
  model = analyzemodel, data = calibration_data, estimator = "MLR",
  missing = "fiml", std.lv = TRUE
)

# Recreate the H1 fit using the same settings as in Section 6.
fit_h1modelfree <- lavaan::cfa(
  model = h1modelfree, data = calibration_data, estimator = "MLR",
  missing = "fiml", std.lv = TRUE
)

# Prepare each model's formatted fit summary.
fit_table_h0 <- table_fit(fit_analyzemodel, lang = "pt")
fit_table_h1 <- table_fit(fit_h1modelfree, lang = "pt")

# Preserve full-precision measures for the values inserted in the text.
fit_data_h0 <- attr(fit_table_h0, "fit_data")
fit_data_h1 <- attr(fit_table_h1, "fit_data")
fit_measures_h0 <- stats::setNames(fit_data_h0$estimate, fit_data_h0$measure)
fit_measures_h1 <- stats::setNames(fit_data_h1$estimate, fit_data_h1$measure)

# Validate the display data before joining and exporting the tables.
fit_display_h0 <- attr(fit_table_h0, "table_data")
fit_display_h1 <- attr(fit_table_h1, "table_data")
if (!is.data.frame(fit_display_h0) || !is.data.frame(fit_display_h1) ||
    nrow(fit_display_h0) == 0L || nrow(fit_display_h1) == 0L) {
  stop("table_data is missing. Reload helpers.R and rerun this chunk.")
}

# Join the displayed values by measure, preserving each model's column.
fit_global <- dplyr::full_join(
  fit_display_h0,
  fit_display_h1,
  by = "Medida",
  suffix = c("_H0", "_H1")
) |>
  dplyr::rename(H0 = Valor_H0, H1 = Valor_H1)

# Export exactly the content displayed in the combined table.
readr::write_excel_csv2(
  fit_global,
  here::here("Output", "Results", "Tables", "tbl-model-fit-global.csv"),
  na = "NA"
)

# Present both model summaries side by side.
fit_global_display <- fit_global
if (knitr::is_latex_output()) {
  fit_global_display$Medida <- gsub(
    "χ²", "$\\chi^2$", fit_global_display$Medida, fixed = TRUE
  )
  fit_global_display$Medida <- gsub(
    "≤", "$\\leq$", fit_global_display$Medida, fixed = TRUE
  )
}
knitr::kable(fit_global_display, format = "pipe", align = c("l", "r", "r"),
  row.names = FALSE)
Os resultados da Tabela 7.1 evidenciam limitações de ajuste em ambas as especificações teóricas. O teste de ajuste exato revelou-se estatisticamente significante em H0, χ²(245) = 764,651 (p <0,001), e em H1, χ²(242) = 712,025 (p <0,001). Como o teste \(\chi^2\) apresenta alta sensibilidade ao tamanho amostral, rejeitando frequentemente discrepâncias de magnitude residual, sua interpretação é articulada aos índices descritivos (Nye, 2022; West et al., 2023).
Os índices incrementais concentram os principais indícios de inadequação nessa avaliação inicial. Em H0, CFI e TLI robustos atingiram 0,895 e 0,882, ao passo que em H1 registraram-se 0,905 e 0,892. Esses coeficientes atestam ganho modesto de ajuste frente ao modelo nulo de independência. Por sua vez, o RMSEA robusto situou-se em 0,063 (IC 90%: 0,058–0,068) em H0 e em 0,060 (IC 90%: 0,055–0,066) em H1, alinhando-se à zona de corte tradicional de 0,06.
O SRMR reportou comportamento mais favorável, marcando 0,054 em H0 e 0,050 em H1. A baixa magnitude média dos resíduos padronizados pode, no entanto, coexistir com focos de desajuste em pares específicos de itens, inspecionados oportunamente na etapa de diagnóstico local. A divergência entre as métricas reforça a necessidade metodológica de interpretá-las conjuntamente (Mai et al., 2021; Niemand & Mai, 2018).
H1 apresenta índices descritivamente superiores, embora o ganho empírico frente a H0 seja discreto. O déficit nos índices incrementais persiste nas duas especificações, nada obstante os níveis aceitáveis de RMSEA e SRMR. A abordagem por simulação complementa esse julgamento ao balizar as distribuições empíricas sob as condições da subamostra de calibração, conforme a estratégia discutida na Seção 2.5. O diagnóstico local examina os pontos em que as discrepâncias se concentram e norteia sua interpretação conceitual.
7.2 Confiabilidade dos escores
A confiabilidade mensura a precisão do escore compósito sob determinadas condições de mensuração. O coeficiente ômega (\(\omega\)) figura como indicador central, estimado a partir das cargas fatoriais e das variâncias residuais do modelo. Essa aferição complementa o ajuste global e depende intrinsecamente da correta especificação fatorial (Cho, 2022; Flora, 2020).
A Tabela 7.2 expõe o ômega e o GLB para os quatro domínios em H0 e H1. Em H1, o fator Psicológico incorpora também Q8 e Q9, enquanto o fator Meio Ambiente agrega Q15, passando a totalizar oito e nove itens, respectivamente. Os demais fatores preservam sua composição original. O GLB é computado separadamente com base na matriz observada de cada modelo, permitindo confrontar os resultados. Como sua dedução algébrica pressupõe independência residual e tende à superestimação amostral em amostras finitas, sua interpretação difere da confiabilidade derivada do modelo estrutural com covariância residual entre Q3 e Q4 (Trizano-Hermosilla & Alvarado, 2016).
| Modelo | Fator | Itens | Ômega | GLB |
|---|---|---|---|---|
| H0 | psycho | 6 | 0.807 | 0.844 |
| H0 | physical | 7 | 0.800 | 0.883 |
| H0 | social | 3 | 0.707 | 0.700 |
| H0 | environment | 8 | 0.781 | 0.836 |
| H1 | psycho | 8 | 0.643 | 0.858 |
| H1 | physical | 7 | 0.729 | 0.883 |
| H1 | social | 3 | 0.707 | 0.700 |
| H1 | environment | 9 | 0.673 | 0.851 |
NotaRacional da Tabela 7.2
Finalidade
Estimar a confiabilidade dos escores de cada domínio, respeitando sua composição em H0 e H1.
Preparação
Utilizam-se fit_analyzemodel e fit_h1modelfree, estimados no bloco da Tabela 7.1.
Procedimento
A função table_reliability(), de helpers.R, recebe cada ajuste e gera a tabela de confiabilidade. A rotina auxiliar tidy_reliability() identifica os indicadores de cada fator e calcula ômega e GLB para os escores unitários. O coeficiente ômega provém de semTools::compRelSEM(), enquanto o GLB utiliza a matriz de correlações observadas mediante psych::glb.algebraic().
A composição reproduz as cargas dos modelos, incluindo as cargas cruzadas postuladas em H1. Ambas as tabelas são verificadas e empilhadas, com a coluna Modelo sinalizando a respectiva especificação. A exportação mantém o mesmo padrão de apresentação.
Execução e resultado
Execute o bloco para exibir os escores dos modelos e salvar tbl-domain-reliability.csv em Output/Results/Tables. O cálculo reaproveita os ajustes em memória, sem demandar reestimação.
Código
# Prepare each model's formatted score reliability table.
reliability_table_h0 <- table_reliability(fit_analyzemodel, lang = "pt")
reliability_table_h1 <- table_reliability(fit_h1modelfree, lang = "pt")

# Validate the display data before combining and exporting the tables.
reliability_display_h0 <- attr(reliability_table_h0, "table_data")
reliability_display_h1 <- attr(reliability_table_h1, "table_data")
if (!is.data.frame(reliability_display_h0) ||
    !is.data.frame(reliability_display_h1) ||
    nrow(reliability_display_h0) == 0L || nrow(reliability_display_h1) == 0L) {
  stop("table_data is missing. Reload helpers.R and rerun this chunk.")
}

# Stack the four factor scores of H0 first and H1 second.
reliability_domains <- dplyr::bind_rows(
  H0 = reliability_display_h0,
  H1 = reliability_display_h1,
  .id = "Modelo"
)

# Export exactly the content displayed in the combined table.
readr::write_excel_csv2(
  reliability_domains,
  here::here("Output", "Results", "Tables", "tbl-domain-reliability.csv"),
  na = "NA"
)

# Present the two model blocks in one table.
knitr::kable(reliability_domains, align = c("l", "l", "r", "r", "r"),
  row.names = FALSE)
No modelo de referência H0, os coeficientes ômega dos quatro domínios situaram-se próximos ou acima do patamar aceitável de 0,70, registrando-se os menores índices no domínio Relações Sociais. Em H1, a consistência dos escores Psicológico e Meio Ambiente recuou para níveis inferiores a essa referência. A avaliação desse recuo deve ponderar a incorporação de itens com cargas secundárias de baixa magnitude, somada à alteração na dimensionalidade teórica dos fatores. A confiabilidade complementa a caracterização psicométrica do instrumento, sem resolver as fragilidades de ajuste global verificadas anteriormente.
7.3 Distribuições dos índices sob os modelos empíricos
A análise de poder (a priori) baseou-se em parâmetros populacionais derivados da literatura e em pressupostos teóricos de planejamento. Uma vez realizada a estimação, as magnitudes de cargas e correlações empíricas afastaram-se daquelas premissas ideais. A avaliação por simulação de Monte Carlo foi, desse modo, reparametrizada pelas matrizes empíricas observadas, preservando a estrutura dos modelos e incorporando o tamanho amostral e as assimetrias distributivas da presente análise (Leite et al., 2023; Moshagen & Bader, 2024). Recalculam-se, assim, os limites fixados no planejamento para os 621 participantes da calibração, considerando os parâmetros estimados, as distribuições marginais e o padrão de dados omissos dessa subamostra. Esse procedimento desloca a questão do dimensionamento amostral prévio para o comportamento empírico esperado dos índices de ajuste sob as condições concretas do estudo.
Os parâmetros estimados delimitam as populações geradoras hipotéticas. Sob a primeira condição, os dados são gerados e modelados sob H0, estabelecendo a distribuição empírica de referência dos índices quando as restrições teóricas do modelo são estritamente satisfeitas. Sob a segunda, os dados são gerados a partir de H1 e estimados por H0, avaliando-se a sensibilidade dos índices à omissão deliberada das três cargas cruzadas especificadas. Esse contraste confere continuidade ao protocolo de planejamento, atualizando as grandezas paramétricas à luz das estimativas da amostra.
A estratégia reúne a localização dos índices observados de H0 frente à sua distribuição nula e a sensibilidade estatística dessa referência diante da má especificação concorrente. Os pontos de corte derivados dos quantis sob H0 refletem a amostragem sob hipótese de ajuste exato, ao passo que a condição alternativa permite averiguar o poder de detecção da omissão estrutural postulada. O procedimento testa uma má especificação direcionada (as três cargas cruzadas), ao passo que a abordagem 3DFI exposta na Seção 2.5 introduz perturbações estocásticas distribuídas na matriz de correlações com magnitude calibrada por MAD (McNeish & Wolf, 2024). As conclusões mantêm-se condicionadas às estimativas pontuais e às distribuições simuladas. Tais estimativas permanecem fixas entre as replicações, cabendo ao Monte Carlo reproduzir o erro de amostragem condicional à subamostra de calibração. O diagnóstico local complementa essa análise ao rastrear anomalias pontuais que escapam ao escopo da alternativa geradora modelada.
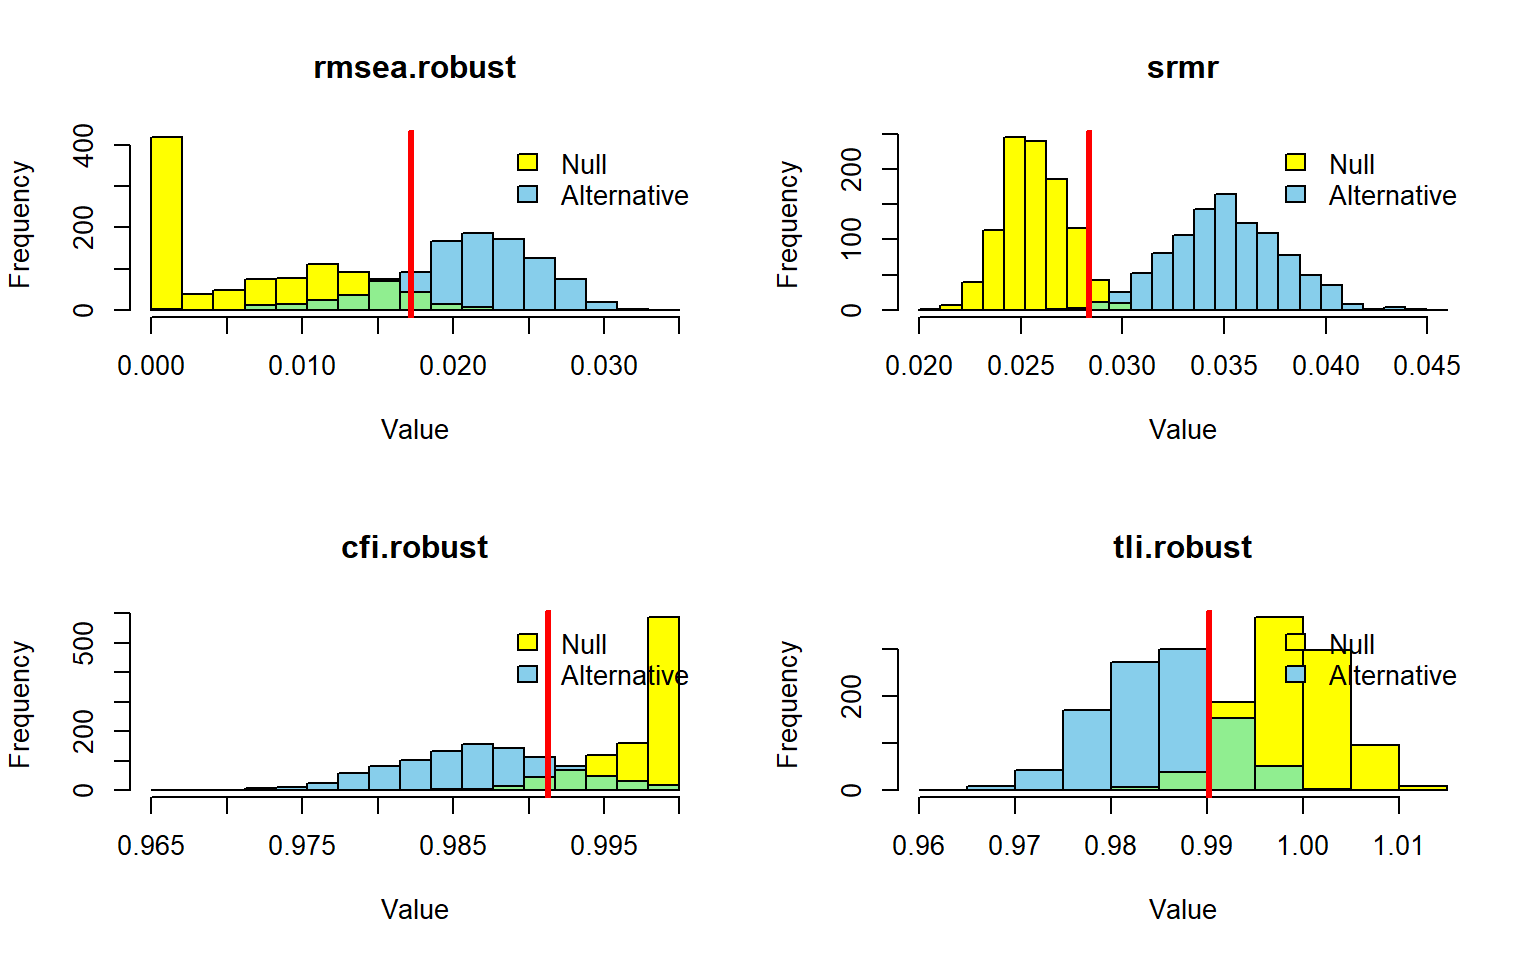
Processaram-se 1.000 replicações de 621 casos em cada condição geradora. A simulação replica as assimetrias e curtoses marginais observadas empiricamente, além de reproduzir o mapa exato de células ausentes da calibração sob o algoritmo MLR/FIML. A Figura 7.1 sintetiza as distribuições de amostragem para RMSEA, CFI e TLI robustos e SRMR, acompanhando as métricas reportadas na Tabela 7.1. A concentração de CFI e TLI em torno de 1 constitui o padrão esperado sob congruência perfeita entre gerador e estimador, permitindo mensurar objetivamente a distância em relação aos dados empíricos observados.
NotaComo as simulações empíricas foram realizadas
Finalidade
Produzir as simulações empíricas sob H0 e H1 que alimentam a avaliação dos índices de ajuste.
Preparação
Utilizam-se calibration_data, fit_analyzemodel e fit_h1modelfree, criados no bloco da Tabela 7.1 para a calibração (sample_group == 0), além de analyzemodel, SIM, SEED e do mecanismo de cache implementado na rotina geral.
Procedimento
O bloco ordena os 24 indicadores da amostra de calibração conforme cada ajuste e obtém a assimetria e curtose observadas para parametrizar as distribuições marginais não normais. A condição de referência gera observações a partir do modelo H0, enquanto a condição concorrente gera a partir de H1. Em ambos os casos, a estimação é aplicada sobre analyzemodel, que impõe a omissão das cargas cruzadas.
As rotinas processam 1.000 replicações com nrow(calibration_data) observações, semente pseudoaleatória SEED, estimador MLR e identificação por variâncias latentes unitárias (std.lv = TRUE). O perfil de dados omissos é fixado em miss, aplicando-se missing = "fiml". A função cache_or_run() reaproveita arquivos RDS previamente gravados, executando a rotina apenas na ausência de cache válido. Os resultados reaproveitados vinculam-se estritamente à mesma partição e aos mesmos ajustes. Instruções operacionais detalhadas constam no README.
Execução e resultado
Execute inicialmente o bloco da Tabela 7.1, seguido da preparação dos momentos marginais e das simulações. Os objetos sim_h0_empirical e sim_h1_empirical fornecem os subsídios para derivação de pontos de corte dinâmicos, cálculo de poder e exibição gráfica. Os dados são persistidos em sim_h0_empirical.rds e sim_h1_empirical.rds no diretório Data/IntermediateData.
Código
# Keep the same 24 indicators in the order used by each fitted model.
indicators_h0 <- calibration_data[
  lavaan::lavNames(fit_analyzemodel, "ov")
]

# Order the same indicators according to the H1 specification.
indicators_h1 <- calibration_data[
  lavaan::lavNames(fit_h1modelfree, "ov")
]

# Use observed marginal skewness and excess kurtosis for data generation.
dist_h0 <- simsem::bindDist(
  skewness = psych::skew(as.matrix(indicators_h0), na.rm = TRUE),
  kurtosis = psych::kurtosi(as.matrix(indicators_h0), na.rm = TRUE)
)

# Define marginal moments for the H1 generating condition.
dist_h1 <- simsem::bindDist(
  skewness = psych::skew(as.matrix(indicators_h1), na.rm = TRUE),
  kurtosis = psych::kurtosi(as.matrix(indicators_h1), na.rm = TRUE)
)

# Reuse or simulate samples from H0 and fit the H0 specification.
sim_h0_empirical <- cache_or_run("sim_h0_empirical", {
  simsem::sim(
    nRep = SIM,
    model = analyzemodel,
    n = nrow(calibration_data),
    generate = fit_analyzemodel,
    indDist = dist_h0,
    miss = simsem::miss(logical = is.na(indicators_h0)),
    lavaanfun = "cfa",
    estimator = "MLR",
    missing = "fiml",
    std.lv = TRUE,
    seed = SEED,
    multicore = TRUE
  )
})

# Reuse or simulate samples from H1 and fit H0 without cross-loadings.
sim_h1_empirical <- cache_or_run("sim_h1_empirical", {
  simsem::sim(
    nRep = SIM,
    model = analyzemodel,
    n = nrow(calibration_data),
    generate = fit_h1modelfree,
    indDist = dist_h1,
    miss = simsem::miss(logical = is.na(indicators_h1)),
    lavaanfun = "cfa",
    estimator = "MLR",
    missing = "fiml",
    std.lv = TRUE,
    seed = SEED,
    multicore = TRUE
  )
})
NotaRacional da Figura 7.1
Finalidade
Obter os limites empíricos dos índices e o poder estatístico de detecção da alternativa geradora, comparando as distribuições de amostragem em ambas as condições.
Preparação
Utilizam-se sim_h0_empirical e sim_h1_empirical, obtidos no callout precedente, além dos parâmetros ALPHA e FITS_ROB da rotina geral.
Procedimento
A calibração deriva da distribuição de amostragem sob H0: percentil 95 para RMSEA robusto e SRMR, e percentil 5 para CFI e TLI robustos. A opção revDirec = TRUE explicita a cauda inferior para os índices incrementais robustos. Esses mesmos pontos de corte alimentam o cômputo de poder estatístico na condição concorrente e o traçado dos gráficos, garantindo estrita consistência entre saídas tabulares e visuais.
O bloco grava a tabela auxiliar de poder e limites em precisão numérica completa, resguardando-a de exibição redundante. A figura integra a distribuição dos quatro índices de ajuste ao lado de seus limiares de decisão.
Execução e resultado
Execute o bloco preparatório dos pontos de corte e, na sequência, o bloco de geração gráfica. O procedimento projeta as curvas de densidade e exporta tbl-empirical-power-cutoffs.csv no diretório Output/Results/Tables.
Código
# Calibrate the 95th percentiles for RMSEA/SRMR and 5th for robust CFI/TLI.
cutoff_fixed <- cbind(
  simsem::getCutoff(
    sim_h0_empirical,
    alpha = ALPHA,
    usedFit = c("rmsea.robust", "srmr")
  ),
  simsem::getCutoff(
    sim_h0_empirical,
    alpha = ALPHA,
    usedFit = c("cfi.robust", "tli.robust"),
    revDirec = TRUE
  )
)

# Apply those same cutoffs to the alternative distribution.
power_fixed <- c(
  simsem::getPowerFit(
    sim_h1_empirical,
    cutoff = unlist(
      cutoff_fixed[1, c("rmsea.robust", "srmr")]
    ),
    usedFit = c("rmsea.robust", "srmr")
  ),
  simsem::getPowerFit(
    sim_h1_empirical,
    cutoff = unlist(
      cutoff_fixed[1, c("cfi.robust", "tli.robust")]
    ),
    usedFit = c("cfi.robust", "tli.robust"),
    revDirec = TRUE
  )
)

# Combine power and cutoffs in one table.
power_cutoff_fixed <- rbind(
  "Poder" = as.numeric(power_fixed),
  "Ponto de corte" = as.numeric(cutoff_fixed[1, ])
)

# Format the fit-index column labels.
colnames(power_cutoff_fixed) <- toupper(names(power_fixed))

# Export the numeric results before display rounding.
write.csv2(
  power_cutoff_fixed,
  here::here("Output", "Results", "Tables", "tbl-empirical-power-cutoffs.csv"),
  row.names = TRUE,
  na = "NA"
)

# Compare robust fit indices and SRMR across the two generating conditions.
simsem::plotPowerFit(
  sim_h1_empirical,
  nullObject = sim_h0_empirical,
  cutoff = unlist(cutoff_fixed[1, ]),
  usedFit = FITS_ROB
)
A Figura 7.1 possibilita contrastar as distribuições teóricas sob H0 com aquelas geradas sob a presença de três cargas cruzadas na população não especificadas no modelo analítico. Adotando-se o nível nominal de significância \(\alpha = 0,05\), os limiares superiores de rejeição situam-se em 0,017 para o RMSEA e 0,028 para o SRMR. Paralelamente, os limites inferiores de corte equivalem a 0,991 para o CFI e 0,990 para o TLI. Ao incidir sobre a distribuição alternativa, esses cortes revelam coeficientes de poder estatístico correspondentes a 80,7%, 99,6%, 80,1% e 80,1%, respectivamente, mensurando a probabilidade do teste em detectar essa má especificação dimensional sob as condições amostrais do estudo.
Nos dados empíricos observados, H0 reportou RMSEA de 0,063 e SRMR de 0,054, enquanto CFI e TLI atingiram 0,895 e 0,882. A projeção desses valores contra as curvas simuladas atesta o afastamento substancial dos índices em relação aos limiares de ajuste exato. No entanto, a detecção da má especificação alternativa não elucida, isoladamente, a origem exata do desajuste observado nem comprova que esse decorra com exclusividade das três cargas cruzadas simuladas. Esses achados tornam obrigatório o aprofundamento do diagnóstico local, articulando a inspeção dos resíduos às premissas da teoria de mensuração e aos antecedentes empíricos da WHOQOL-Bref.
7.4 Diagnóstico local
O diagnóstico local tem por objetivo mapear as fontes específicas de discrepâncias empíricas que podem culminar no desajuste global observado. Essa investigação conjuga as estimativas fatoriais da Tabela 6.1 aos índices de modificação (MI), às mudanças esperadas nos parâmetros (EPC) e à matriz de resíduos de correlação, conforme prescrito na Seção 2.5. A análise concentra-se prioritariamente em H0, modelo teórico de referência que orienta as decisões de reespecificação.
7.4.1 MI e EPC
O MI estima a redução teórica na estatística \(\chi^2\) proporcionada pela liberação individual de cada parâmetro previamente fixado. O EPC projeta a magnitude esperada da referida estimativa livre, e sua versão padronizada viabiliza a comparação direta do impacto paramétrico. Essas métricas devem ser interpretadas conjuntamente com as cargas fatoriais, com a magnitude dos resíduos e com o fundamento conceitual da relação analisada (Nye, 2022). A Tabela 7.3 consolida os vinte maiores MI de H0 com seus respectivos EPC brutos e padronizados.
| Relação | MI | EPC | EPC padronizado |
|---|---|---|---|
| Q17 ~~ Q18 | 82.261 | 0.158 | 0.794 |
| Q5 ~~ Q14 | 62.470 | 0.159 | 0.358 |
| environment =~ Q5 | 48.605 | 0.362 | 0.442 |
| environment =~ Q15 | 48.113 | 0.313 | 0.366 |
| psycho =~ Q10 | 41.600 | 0.552 | 0.591 |
| Q24 ~~ Q25 | 34.822 | 0.179 | 0.256 |
| Q3 ~~ Q15 | 30.427 | 0.125 | 0.202 |
| psycho =~ Q17 | 26.402 | -0.408 | -0.442 |
| Q10 ~~ Q18 | 26.359 | -0.088 | -0.269 |
| Q5 ~~ Q6 | 25.744 | 0.111 | 0.223 |
| psycho =~ Q24 | 25.655 | -0.324 | -0.341 |
| Q15 ~~ Q17 | 23.512 | -0.076 | -0.267 |
| Q23 ~~ Q25 | 23.341 | 0.148 | 0.213 |
| Q11 ~~ Q10 | 21.303 | 0.100 | 0.202 |
| environment =~ Q17 | 20.282 | -0.155 | -0.167 |
| physical =~ Q5 | 20.123 | -0.377 | -0.460 |
| Q19 ~~ Q18 | 20.050 | 0.068 | 0.230 |
| Q12 ~~ Q23 | 19.257 | -0.139 | -0.211 |
| social =~ Q23 | 18.360 | 0.225 | 0.229 |
| environment =~ Q10 | 18.223 | 0.177 | 0.189 |
NotaRacional da Tabela 7.3
Finalidade
Organizar as vinte maiores relações candidatas à liberação em H0, com seus MI e EPC.
Preparação
Utiliza-se fit_analyzemodel, estimado no início dessa seção.
Procedimento
A função table_mi(), de helpers.R, utiliza lavaan::modindices(object, sort. = TRUE) para obter os MI em ordem decrescente, com EPC bruto e padronizado (sepc.all). O próprio lavaan exclui parâmetros já livres e MI indisponíveis. A rotina apresenta as primeiras vinte relações, preserva os operadores lavaan e formata os valores com três casas decimais. O argumento top_n permite alterar o número de linhas; top_n = NULL apresenta todas.
O atributo mi_data preserva a saída completa do lavaan, recuperada em mi_all para uso no texto. Por isso, a extração é feita uma única vez e head() limita apenas as linhas apresentadas. Para obter diretamente apenas os vinte maiores MI, a chamada nativa equivalente é lavaan::modindices(fit_analyzemodel, sort. = TRUE, maximum.number = 20). O atributo table_data contém as vinte relações apresentadas e é exportado com os mesmos rótulos e valores de exibição.
Execução e resultado
Execute o bloco para apresentar a tabela e salvar tbl-modification-indices-top20.csv em Output/Results/Tables. O procedimento diagnostica o ajuste existente, sem estimar um modelo modificado.
Código
# Prepare the twenty largest modification indices for H0 in Portuguese.
mi_table_h0 <- table_mi(fit_analyzemodel, lang = "pt")

# Preserve all full-precision candidates for the values inserted in the text.
mi_all <- attr(mi_table_h0, "mi_data")

# Validate and export exactly the content displayed in the table.
mi_table_data_h0 <- attr(mi_table_h0, "table_data")
if (!is.data.frame(mi_table_data_h0) || nrow(mi_table_data_h0) == 0L) {
  stop("table_data is missing or empty. Reload helpers.R and check the model.")
}
readr::write_excel_csv2(
  mi_table_data_h0,
  here::here("Output", "Results", "Tables", "tbl-modification-indices-top20.csv"),
  na = "NA"
)

# Present the formatted modification index table.
mi_table_h0
7.4.2 Resíduos de correlação
Os resíduos de correlação indicam a magnitude em que cada associação bivariada entre indicadores é subestimada ou superestimada pela estrutura teórica do modelo. Essa métrica evidencia discrepâncias locais ocultas nos resumos globais (Crede & Harms, 2019; Nye, 2022).
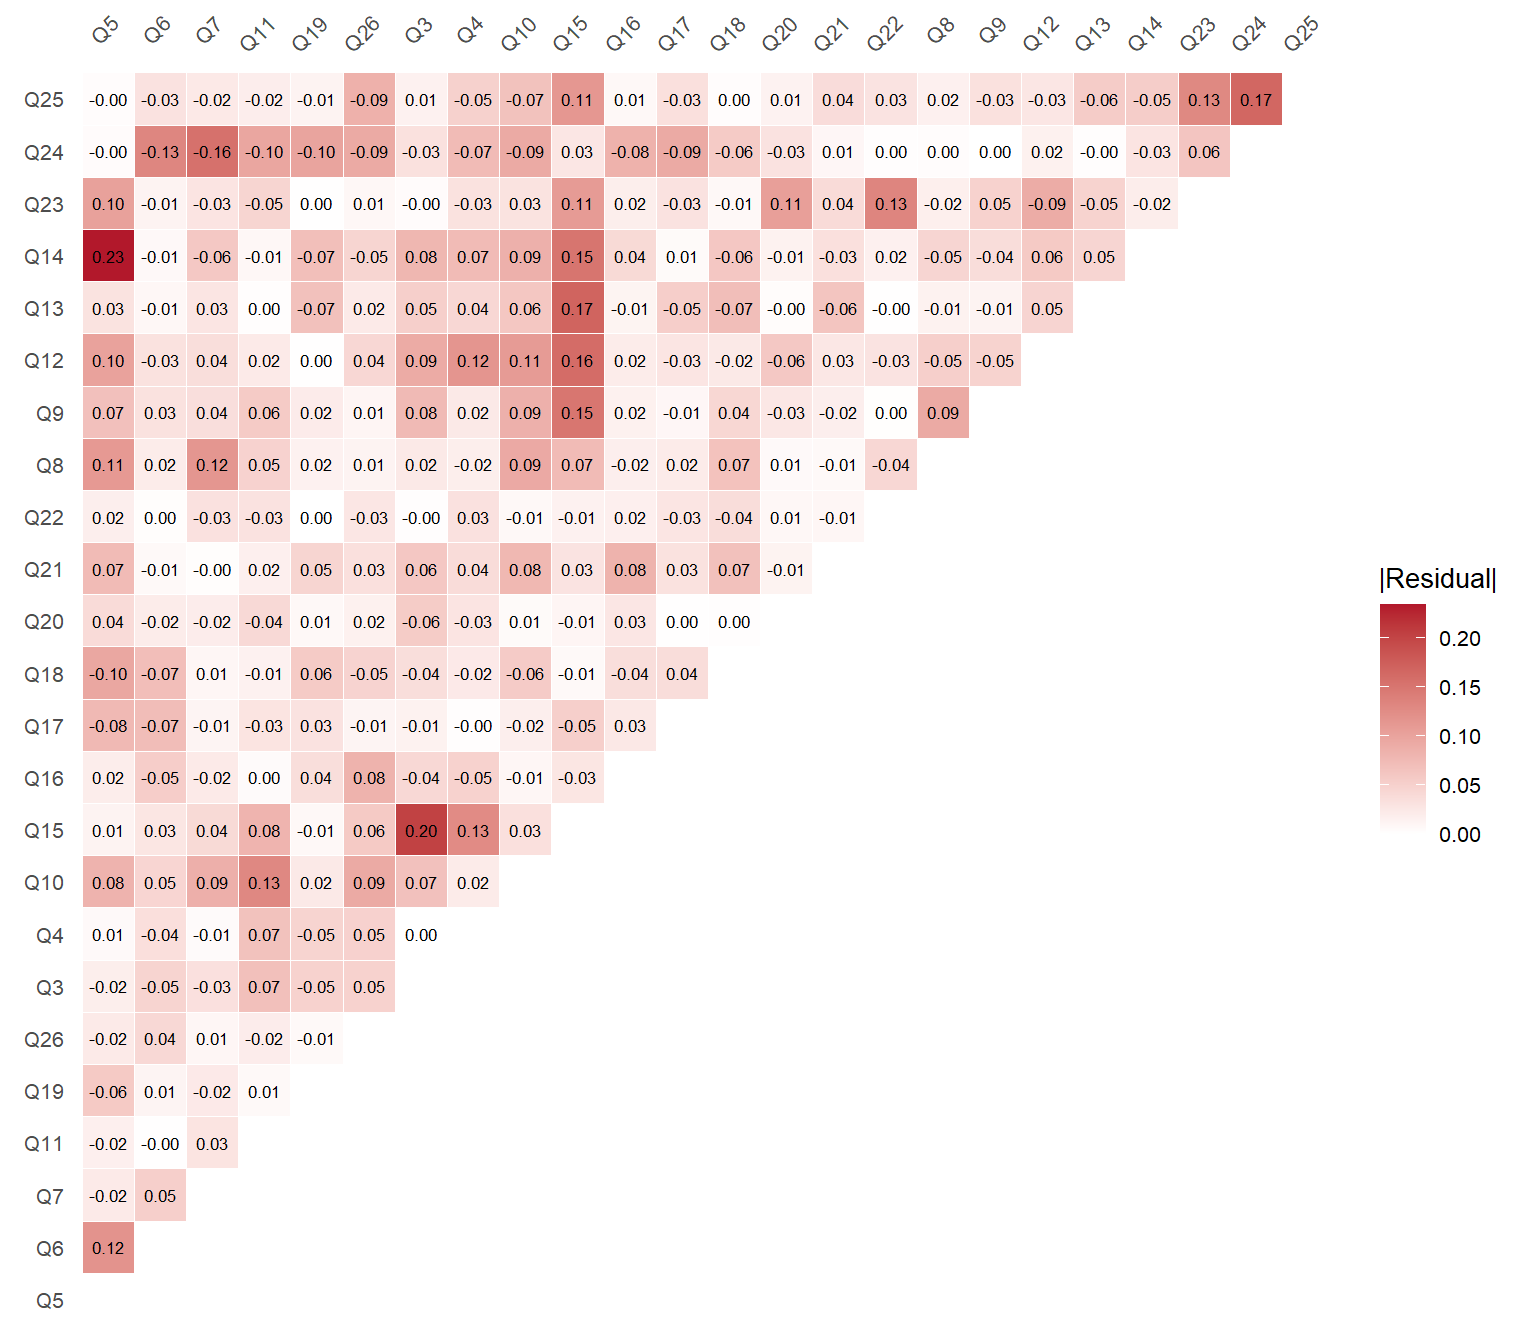
A Figura 7.2 esquematiza a matriz de resíduos de H0, dispondo os itens na sequência fatorial do modelo. A intensidade da gradação cromática traduz o valor absoluto do resíduo, ao passo que os valores numéricos informam o sinal aritmético da discrepância. Cada par bivariado é representado uma única vez. O limiar de relevância prática de \(|r_{res}| \geq 0,10\), fundamentado na Seção 2.5, norteia o escrutínio conjunto com os MI, os EPC e a redação dos itens.
NotaRacional da Figura 7.2
Finalidade
Localizar diferenças entre as correlações observadas e reproduzidas por H0 em um mapa de resíduos.
Preparação
Utilizam-se fit_analyzemodel, estimado no início dessa seção, e a função plot_stdres() de helpers.R.
Procedimento
plot_stdres() recebe o ajuste e retorna um gráfico ggplot. Sua auxiliar tidy_stdres() organiza os resíduos obtidos por lavaan::lavResiduals(), utilizando as estatísticas observadas do ajuste com FIML. Os resíduos são diferenças de correlação, sem conversão em estatísticas z.
O mapa mantém a ordem dos indicadores, apresenta cada par uma vez e omite a diagonal. A cor representa a magnitude absoluta, enquanto os rótulos preservam o sinal e exibem duas casas decimais. Os atributos residual_matrix e residual_data conservam, respectivamente, a matriz completa e os pares com precisão original para exportação e valores no texto.
Execução e resultado
Execute o bloco para apresentar o mapa e salvar residual-correlations-h0.csv em Output/Results/Tables e fig-residual-correlations.png em Output/Results/Figures.
Código
# Create the correlation residual heatmap.
residual_heatmap <- plot_stdres(fit_analyzemodel)

# Preserve full-precision residuals for export and inline results.
residual_matrix_h0 <- attr(residual_heatmap, "residual_matrix")
residual_correlations <- attr(residual_heatmap, "residual_data")

# Export the complete correlation residual matrix.
write.csv2(
  residual_matrix_h0,
  here::here("Output", "Results", "Tables", "residual-correlations-h0.csv"),
  row.names = TRUE, na = "NA"
)

# Save the residual correlation heatmap.
ggplot2::ggsave(
  here::here("Output", "Results", "Figures", "fig-residual-correlations.png"),
  plot = residual_heatmap, width = 8, height = 7, dpi = 300
)

# Display the residual correlation heatmap.
residual_heatmap
O diagnóstico local de H0 inspeciona inicialmente os três itens cujas cargas secundárias foram especificadas no modelo alternativo H1. Em relação a Q15, a carga cruzada no fator Meio Ambiente figura com destaque entre os maiores MI (MI = 48,113, EPC padronizado = 0,366). O indicador apresenta também resíduos correlacionais positivos expressivos com Q3 e Q4, da ordem de 0,20 e 0,13, indicando covariações bivariadas subestimadas pela estrutura confirmatória pura. Para os itens Q8 e Q9, sobressai a covariância residual entre seus termos de erro (MI = 10,847, EPC padronizado = 0,143), corroborada por resíduo de correlação positivo de 0,09. Esses dados expõem discrepâncias de mensuração nos itens englobados pela formulação de H1, nada obstante a dependência residual entre Q8 e Q9 não comprovar, por si só, a existência de cargas adicionais no domínio Psicológico.
O escrutínio diagnóstico revela, ademais, pontos críticos de desajuste alheios às relações antecipadas por H1. O item Q5 concentra indicações recorrentes de cargas secundárias nos domínios Físico e Meio Ambiente, além de correlação residual com Q6 e Q14. O resíduo de correlação no par Q5–Q14, de 0,235, estabelece a discrepância empírica de maior magnitude em toda a matriz. Por sua vez, o item Q24 combina carga primária modesta, demanda de carga cruzada no fator Psicológico e forte associação de erro com Q25, cujo resíduo de correlação alcança 0,166. Integrados aos desvios de Q15, esses achados qualificam Q5, Q15 e Q24 como os principais candidatos à investigação de modificações estruturais na calibração. O item Q8 mantém-se como candidato suplementar, dada a magnitude modesta de sua carga primária e a dependência residual com Q9. Paralelamente, as cargas atenuadas de Q3/Q4 e a covariação residual entre Q17 e Q18 também integram o inventário de desajustes, expressando particularidades de mensuração da escala.
A análise global evidenciou fragilidades de ajustamento nas especificações originais. O protocolo de simulação proveu distribuições de referência condicionais às propriedades da subamostra de calibração, balizando o julgamento dos índices obtidos. A leitura integrada de parâmetros, resíduos de correlação e indicadores de modificação isolou as fontes prioritárias de desajuste nos itens da escala. Essas evidências justificam a exploração de reespecificações, cujo critério de elegibilidade pressupõe a convergência com a teoria de mensuração e a integridade de cobertura dos domínios. Na Seção 8, essas hipóteses serão confrontadas com a literatura pregressa para fundamentar a especificação ajustada e suas diretrizes operacionais, sendo o modelo final validado de maneira independente na subamostra de validação.