| Componente | Especificação | Base |
|---|---|---|
| Modelo de referência | Quatro fatores correlacionados e covariância residual Q3–Q4 | Lin e Yao (2022) |
| Misspecificação | Omissão de três cargas cruzadas | Mosqueira-Taipe et al. (2026) |
| Não normalidade | Assimetria de -1 a +1; curtose entre 1,7 e 2,0 | Yoshitake et al. (2015) |
| Dados ausentes | 10% MCAR | Mosqueira-Taipe et al. (2026) |
| Estimação | MLR + FIML | Cenário realístico |
| Erro tipo I | 0.05 | Definido a priori |
| Poder-alvo | 0.80 | Definido a priori |
4 Análise de poder
Em pesquisas empíricas, a escala psicométrica atua frequentemente como modelo de mensuração de construtos latentes a serem integrados em um modelo estrutural posterior. O planejamento amostral deve fundamentar-se no instrumento específico e na estrutura fatorial a ser estimada, superando regras heurísticas genéricas sobre o número de itens ou parâmetros livres (Kline, 2023). Nessa seção, define-se o poder estatístico como a probabilidade de detectar uma omissão estrutural formalmente delimitada antes da coleta de dados.
4.1 Pressupostos a priori
O planejamento da AP ancora-se nas duas especificações do modelo de medida fundamentadas na Seção 3. Nessa análise, o segundo modelo representa a condição populacional alternativa na qual a adoção da estrutura parcimoniosa implica a omissão deliberada de três cargas cruzadas.
As cargas fatoriais principais, as correlações inter-fatores e as variâncias residuais foram parametrizadas com base nas evidências meta-analíticas e revisões sistemáticas prévias (Lin & Yao, 2022; Mosqueira Taipe et al., 2026; Skevington & Epton, 2018). Dessa forma, a AP é conduzida estritamente a priori: as características populacionais e a magnitude da má especificação são estabelecidas antes do acesso aos dados empíricos examinados nas seções posteriores.
Além da configuração fatorial, as simulações incorporam duas condições metodológicas frequentes na aplicação da AFC: desvios de normalidade e dados omissos. A distribuição dos indicadores contempla assimetrias entre \(-1\) e \(+1\) e curtose entre 1,7 e 2,0, refletindo desvios moderados de normalidade compatíveis com dados empíricos da escala WHOQOL-Bref (Yoshitake et al., 2015).
Admite-se, igualmente, que 10% das respostas estejam ausentes sob o mecanismo completamente ao acaso (Missing Completely at Random, MCAR). A adoção desse padrão modela a perda informacional sem demandar hipóteses condicionais complexas sobre variáveis auxiliares. Em todas as condições experimentais, os parâmetros são estimados por MLR, associada ao tratamento de dados omissos por FIML. A Tabela 4.1 sintetiza as especificações adotadas.
NotaRacional da Tabela 4.1
Finalidade
Sintetizar as decisões metodológicas que delimitam o cenário da AP, relacionando cada especificação paramétrica ao seu respectivo embasamento na literatura.
Preparação
Utilize as constantes ALPHA e POWER de helpers.R, conforme a rotina preparatória descrita na Seção 3.
Procedimento
O bloco organiza as premissas em power_assumptions, estruturando três colunas: componente, especificação e fundamentação. As constantes globais mantêm o nível de significância nominal e o poder estatístico desejado perfeitamente sincronizados com as análises posteriores. A instrução final compila a tabela formatada.
Execução e resultado
Execute o bloco para gerar a estrutura power_assumptions e renderizar a síntese dos pressupostos.
Código
# Summarize the assumptions used for power analysis.
power_assumptions <- tribble(
  ~component, ~specification, ~basis,
  "Modelo de referência",
  "Quatro fatores correlacionados e covariância residual Q3--Q4",
  "Lin e Yao (2022)",
  "Misspecificação",
  "Omissão de três cargas cruzadas",
  "Mosqueira-Taipe et al. (2026)",
  "Não normalidade",
  "Assimetria de -1 a +1; curtose entre 1,7 e 2,0",
  "Yoshitake et al. (2015)",
  "Dados ausentes", "10% MCAR", "Mosqueira-Taipe et al. (2026)",
  "Estimação", "MLR + FIML", "Cenário realístico",
  "Erro tipo I", format(ALPHA, nsmall = 2), "Definido a priori",
  "Poder-alvo", format(POWER, nsmall = 2), "Definido a priori"
)

# Present the summary table.
kable(
  power_assumptions,
  col.names = c("Componente", "Especificação", "Base"),
  align = c("l", "l", "l")
)
4.2 Abordagem analítica de poder
A primeira estimativa do tamanho amostral mínimo decorre da derivação analítica baseada em modelos. Nessa abordagem, a população geradora incorpora as três cargas cruzadas teóricas, ao passo que o modelo estimado restringe a análise às cargas principais e à covariância residual entre Q3 e Q4. A magnitude do efeito decorre da discrepância populacional entre a matriz implicada e as restrições estruturais impostas pelo modelo de análise (Moshagen & Bader, 2024).
Sem a especificação de um modelo alternativo aninhado estimado livremente, o teste avalia o ajuste global do modelo de análise frente ao modelo saturado. Dessa forma, a hipótese estatística quantifica a probabilidade de rejeitar formalmente a estrutura parcimoniosa diante da presença real das cargas cruzadas na população.
Adotando-se nível de significância de 5% e poder estatístico-alvo de 80%, o procedimento analítico indicou a necessidade de um tamanho amostral mínimo de 106 participantes. Esse valor opera como baliza inicial para os estudos de simulação, e não como determinação amostral definitiva.
A Tabela 4.2 apresenta as métricas resultantes da derivação analítica e o tamanho de amostra necessário para alcançar o poder estabelecido.
| Medida | Símbolo | Valor |
|---|---|---|
| Discrepância populacional | \(F_0\) | 0.579 |
| Raiz do erro quadrático médio de aproximação | \(\text{RMSEA}\) | 0.049 |
| Índice de centralidade de McDonald | \(Mc\) | 0.749 |
| Índice de qualidade do ajuste | \(\text{GFI}\) | 0.954 |
| Índice de qualidade do ajuste ajustado | \(\text{AGFI}\) | 0.944 |
| Raiz do resíduo quadrático médio padronizado | \(\text{SRMR}\) | 0.067 |
| Índice de ajuste comparativo | \(\text{CFI}\) | 0.960 |
| Graus de liberdade | \(df\) | 245 |
| Tamanho amostral necessário | \(N\) | 106 |
| Qui-quadrado crítico | \(\chi^2_{\text{crit}}\) | 282.511 |
| Parâmetro de não centralidade | \(\lambda\) | 60.793 |
| Nível de significância (alfa) | \(\alpha\) | 0.050 |
| Erro tipo II (beta) | \(\beta\) | 0.1968 |
| Poder estatístico | \(1 - \beta\) | 0.8032 |
NotaRacional da Tabela 4.2
Finalidade
Calcular o tamanho amostral necessário para detectar as relações estruturais omitidas pelo modelo de análise e apresentar as métricas da abordagem analítica de AP.
Preparação
Utilize os objetos h1model e analyzemodel, definidos em models.R, e as constantes globais ALPHA, POWER e P de helpers.R.
Procedimento
A função semPower.powerLav() compara a população com três cargas cruzadas ao modelo de análise que as restringe a zero. O argumento type = "a-priori" especifica a derivação prospectiva de tamanho amostral, enquanto lavOptions = list(std.lv = TRUE) estabelece a identificação por variâncias latentes unitárias. O resultado é atribuído ao objeto ap_h1model.
A rotina autoral table_sempower() estrutura esse resultado em tabela padronizada em português. Internamente, tidy_sempower() extrai as métricas e format_metric_val() ajusta a notação numérica. O tamanho amostral e o poder exibidos correspondem às soluções diretas do cálculo analítico.
readr::write_excel_csv2() salva os mesmos dados formatados em Output/Results/Tables/tbl-analytical-power.csv, com separador ponto e vírgula e codificação compatível com Excel.
Execução e resultado
Execute o bloco para calcular ap_h1model e compilar a tabela de indices. O objeto gerado é reaproveitado no gráfico subsequente.
Código
# Calculate the required sample size from the specified models.
ap_h1model <- semPower.powerLav(
  type = "a-priori",
  alpha = ALPHA,
  power = POWER,
  modelPop = h1model,
  modelH0 = analyzemodel,
  lavOptions = list(std.lv = TRUE),
  p = P
)

# Save the table data as CSV.
readr::write_excel_csv2(
  tidy_sempower(ap_h1model, lang = "pt"),
  here::here("Output", "Results", "Tables", "tbl-analytical-power.csv")
)

# Present the analytical power results separately from the plot.
table_sempower(ap_h1model, lang = "pt")
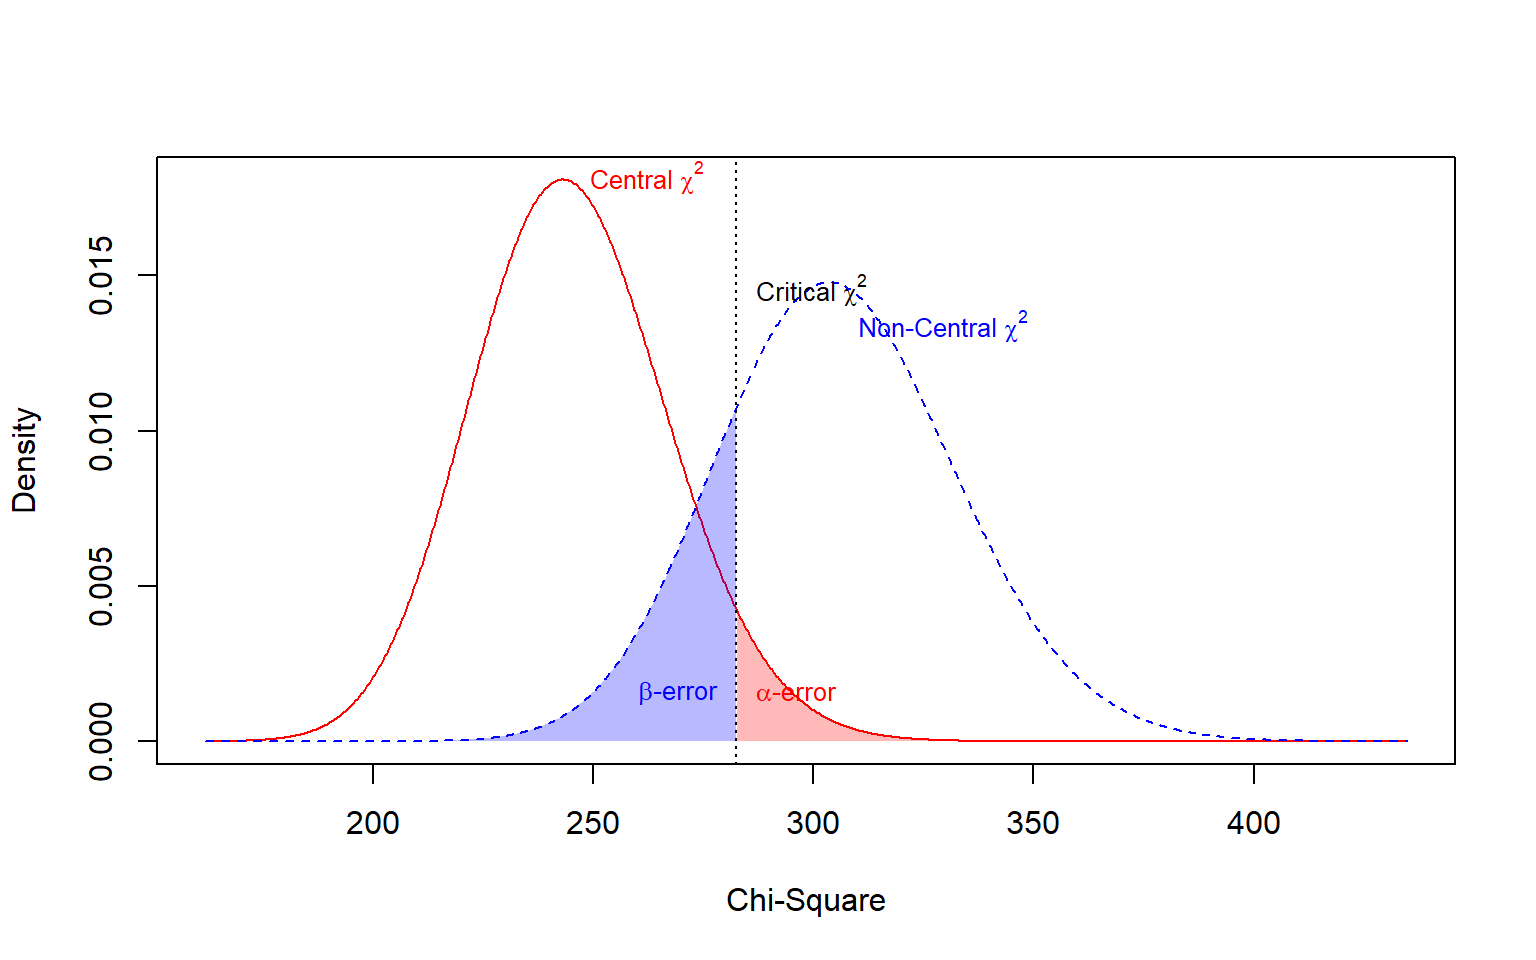
A Figura 4.1 ilustra as distribuições central e não central do qui-quadrado. A distribuição sob a hipótese nula representa o comportamento esperado da estatística sob correta especificação estrutural, ao passo que a distribuição não central projeta a dispersão diante da discrepância populacional estipulada. A área de rejeição e a sobreposição das curvas expressam graficamente a relação entre o erro Tipo I e o poder estatístico do teste.
NotaRacional da Figura 4.1
Finalidade
Representar visualmente as distribuições teóricas da estatística de teste e as regiões de decisão subjacentes ao cálculo analítico de poder.
Preparação
Utilize o objeto ap_h1model, calculado na etapa da Tabela 4.2.
Procedimento
A rotina autoral plot_sempower() processa os parâmetros do teste (valor crítico, graus de liberdade e parâmetro de não centralidade) e desenha as curvas por meio de semPower::semPower.showPlot(). A instrução preserva a rotulagem gráfica e exibe apenas o diagrama.
Execução e resultado
Execute o bloco para renderizar o gráfico a partir do objeto ap_h1model.
Código
# Plot the chi-square distributions without the console summary.
plot_sempower(ap_h1model)
4.3 SMC com tamanho amostral variável
Embora a derivação assintótica forneça uma estimativa inicial objetiva, não reproduz integralmente as condições empíricas observadas na prática da pesquisa. Dessa forma, a fase subsequente implementa uma SMC combinando desvios moderados de normalidade e 10% de dados omissos MCAR, preservando-se a estimação por MLR com tratamento via FIML.
Os tamanhos amostrais variam de 101 a 400 participantes. Para cada tamanho de amostra, geram-se dez replicações sob duas condições populacionais: na condição de referência, os dados reproduzem o modelo de quatro fatores sem cargas cruzadas; na condição alternativa, os dados incorporam as três cargas secundárias, mas são estimados pelo modelo parcimonioso. O confronto dessas condições permite estimar o poder empírico dos índices RMSEA, SRMR, CFI e TLI na identificação da má especificação planejada.
NotaComo as simulações com N variável foram realizadas
Finalidade
Gerar as condições populacionais de referência e alternativa para avaliar o poder dos índices de ajuste entre 101 e 400 participantes.
Preparação
Utilize popmodel, h1model e analyzemodel, definidos em models.R, e as constantes SEQ, P_MCAR, DIST e SEED, de helpers.R, conforme a preparação geral da Seção 3.
Procedimento
As chamadas a sim() ajustam analyzemodel nas duas condições. O argumento generate seleciona a população de origem: popmodel representa a referência e h1model acrescenta as três cargas cruzadas omitidas na estimação. O vetor SEQ = rep(101:400, each = REP), com REP = 10, determina dez replicações por tamanho amostral, totalizando 3.000 por condição. DIST define os momentos marginais não normais, e P_MCAR = 0.10 introduz 10% de respostas ausentes MCAR. A estimação utiliza MLR, FIML e variâncias latentes unitárias (std.lv = TRUE), com semente SEED e processamento paralelo (multicore = TRUE).
Execução e resultado
Execute o bloco para obter popmodel_varying e h1model_varying, utilizados nas duas curvas de poder e na tabela para N = 150. cache_or_run() reaproveita os objetos em memória ou os arquivos popmodel_101to400.rds e h1model_101to400.rds, em Data/IntermediateData; na ausência deles, executa e salva as simulações. Orientações para recálculo constam no README.
Código
# Reuse or simulate the reference population across sample sizes.
popmodel_varying <- cache_or_run("popmodel_101to400", {
  sim(
    NULL,
    n = SEQ,
    pmMCAR = P_MCAR,
    analyzemodel,
    generate = popmodel,
    indDist = DIST,
    std.lv = TRUE,
    lavaanfun = "cfa",
    estimator = "mlr",
    missing = "fiml",
    seed = SEED,
    multicore = TRUE
  )
})

# Reuse or simulate the alternative population across sample sizes.
h1model_varying <- cache_or_run("h1model_101to400", {
  sim(
    NULL,
    n = SEQ,
    pmMCAR = P_MCAR,
    analyzemodel,
    generate = h1model,
    indDist = DIST,
    std.lv = TRUE,
    lavaanfun = "cfa",
    estimator = "mlr",
    missing = "fiml",
    seed = SEED,
    multicore = TRUE
  )
})
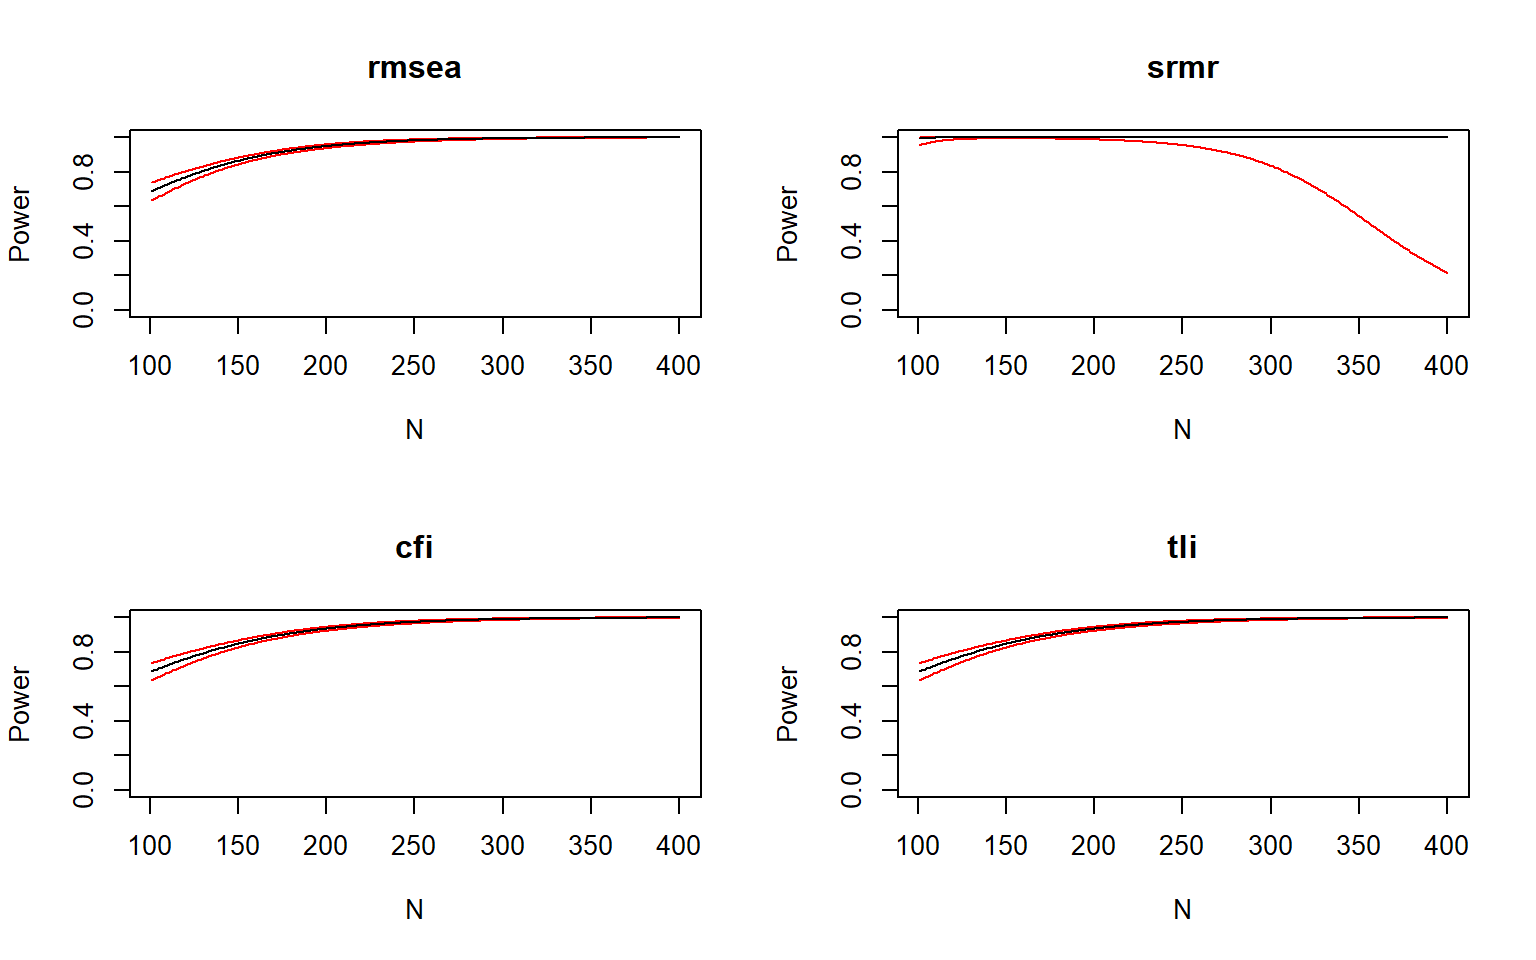
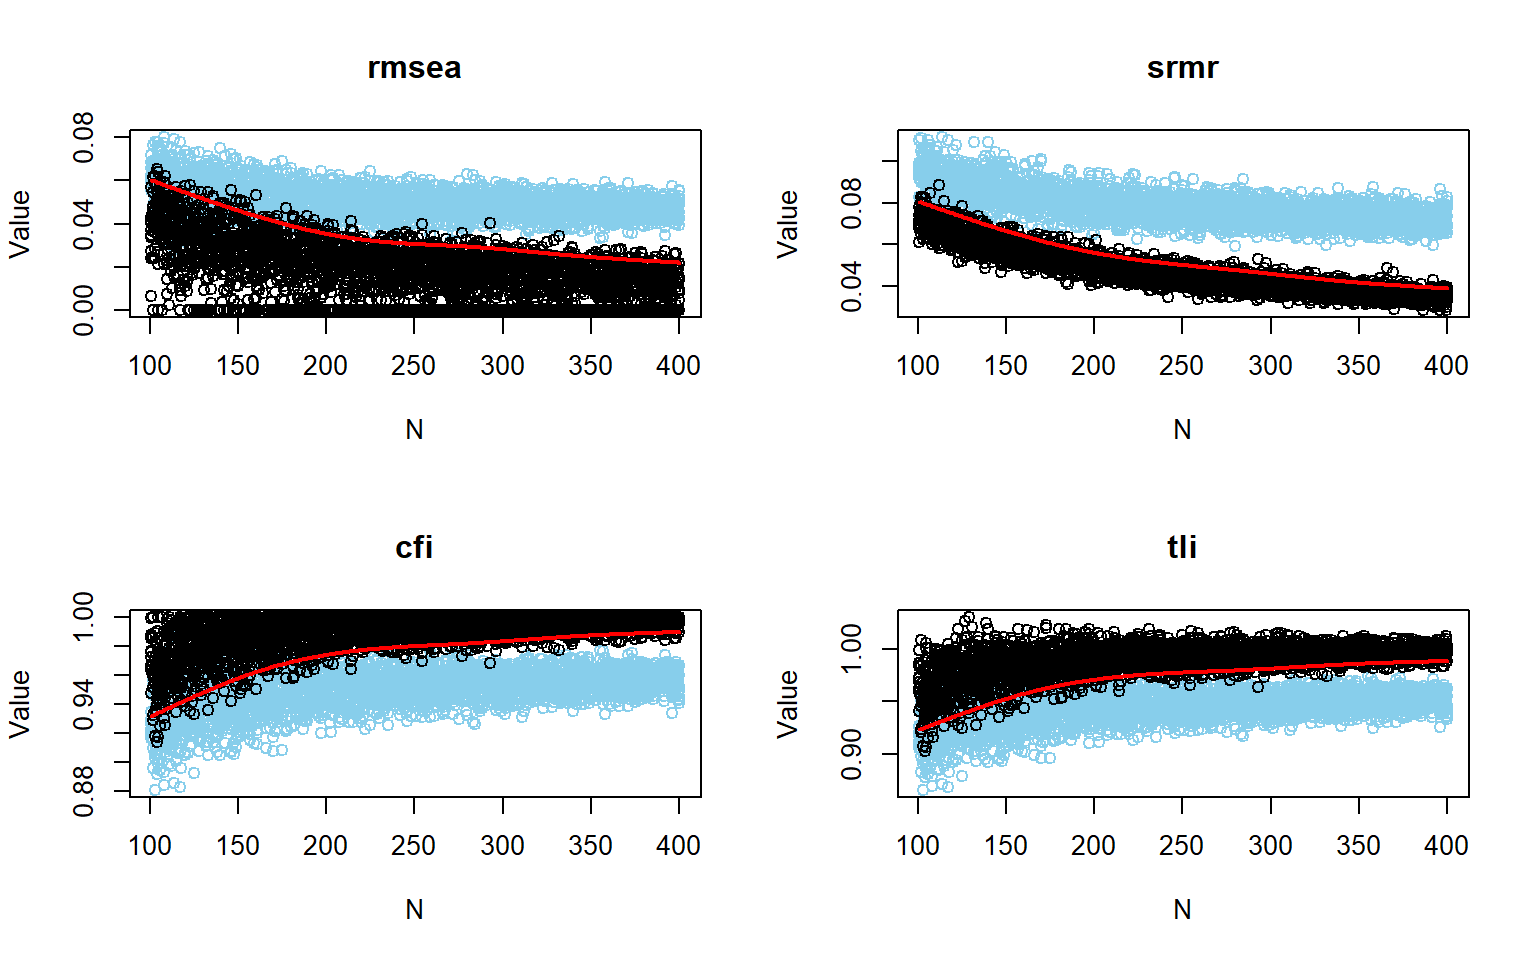
Apresentam-se duas configurações gráficas da relação entre tamanho amostral e poder estatístico. A primeira adota suavização logística para destacar a trajetória de evolução do poder ao longo do gradiente amostral (Figura 4.2). A segunda exibe diretamente as taxas empíricas de rejeição observadas nas replicações realizadas em cada patamar (Figura 4.3).
NotaRacional da Figura 4.2
Finalidade
Contrastar a trajetória do poder estatístico ao longo de diferentes tamanhos amostrais sob correta especificação e sob omissão das cargas cruzadas.
Preparação
Utilize popmodel_varying e h1model_varying, obtidos no callout “Como as simulações com N variável foram realizadas”, além de ALPHA e FITS.
Procedimento
plotPowerFit() utiliza a distribuição simulada sob a condição de referência para definir os limites de rejeição e estima o poder na condição alternativa. O argumento usedFit = FITS seleciona RMSEA, SRMR, CFI e TLI. A suavização logística padrão resume a trajetória do poder ao longo dos tamanhos amostrais.
Execução e resultado
Execute o bloco para apresentar as curvas suavizadas a partir dos resultados das simulações já disponíveis.
Código
# Plot power across sample sizes.
plotPowerFit(
  h1model_varying,
  popmodel_varying,
  alpha = ALPHA,
  usedFit = FITS
)
NotaRacional da Figura 4.3
Finalidade
Inspecionar as taxas de poder estatístico observadas em cada tamanho amostral sem a interpolação das curvas logísticas.
Preparação
Utilize os objetos popmodel_varying e h1model_varying, obtidos no callout “Como as simulações com N variável foram realizadas”.
Procedimento
A instrução reaproveita os resultados das simulações, alterando apenas o parâmetro para logistic = FALSE. Esse ajuste vincula as estimativas pontuais de poder em cada patamar amostral, revelando a variabilidade amostral resumida pelo modelo logístico. Mantêm-se os índices e as condições especificadas.
Execução e resultado
Execute o bloco para renderizar as curvas empíricas sem suavização.
Código
# Plot the unsmoothed power curves.
plotPowerFit(
  h1model_varying,
  popmodel_varying,
  alpha = ALPHA,
  usedFit = FITS,
  logistic = FALSE
)
As curvas apresentadas na Figura 4.2 e na Figura 4.3 indicam que uma amostra próxima a 150 respondentes atinge sensibilidade suficiente para que os índices globais identifiquem a omissão das cargas cruzadas. Calculam-se, então, o poder e os pontos de corte empíricos especificamente para \(N = 150\). Essa verificação permite aferir se o patamar indicado visualmente pelas curvas mantém estabilidade entre os quatro índices globais ou se opera excessivamente próximo do limiar crítico.
| RMSEA | SRMR | CFI | TLI | |
|---|---|---|---|---|
| Poder | 0.864 | 0.999 | 0.847 | 0.847 |
| Ponto de corte | 0.046 | 0.068 | 0.957 | 0.951 |
NotaRacional da Tabela 4.3
Finalidade
Consolidar o poder empírico e os pontos de corte calibrados pelo modelo para o tamanho amostral de 150 participantes.
Preparação
Utilize os objetos popmodel_varying e h1model_varying, obtidos no callout “Como as simulações com N variável foram realizadas”, e as constantes ALPHA e FITS.
Procedimento
O poder é estimado na condição alternativa, adotando a distribuição sob correta especificação para definir as zonas de rejeição. As rotinas são parametrizadas com nVal = 150 sob o mesmo nível de significância: getPowerFit() quantifica o poder e getCutoff() recupera os limiares correspondentes. O bloco consolida ambas as informações em power_cutoff_varying, organizando as colunas pelos índices analisados.
readr::write_csv2() salva os valores sem arredondamento em Output/Results/Tables/tbl-power-cutoff-realistic.csv. A coluna Medida preserva os nomes das linhas “Poder” e “Ponto de corte”.
Execução e resultado
Execute o bloco para renderizar a tabela contendo o poder e os pontos de corte calculados para a amostra de 150 indivíduos.
Código
# Estimate power at N = 150 using model-calibrated cutoffs.
power_varying <- getPowerFit(
  h1model_varying,
  nullObject = popmodel_varying,
  alpha = ALPHA,
  nVal = 150,
  usedFit = FITS
)

# Extract the model-calibrated cutoffs at N = 150.
cutoff_varying <- getCutoff(
  popmodel_varying,
  alpha = ALPHA,
  nVal = 150,
  usedFit = FITS
)

# Combine power and cutoffs in one table.
power_cutoff_varying <- rbind(
  "Poder" = as.numeric(power_varying),
  "Ponto de corte" = as.numeric(cutoff_varying[1, ])
)

# Format the fit-index column labels.
colnames(power_cutoff_varying) <- toupper(names(power_varying))

# Save the table data as CSV.
readr::write_csv2(
  tibble::rownames_to_column(as.data.frame(power_cutoff_varying), "Medida"),
  here::here("Output", "Results", "Tables", "tbl-power-cutoff-realistic.csv")
)

# Present the summary table.
kable(power_cutoff_varying, digits = 3, align = "c")
Em \(N=150\), o poder estimado atingiu 0.864 para o RMSEA, 0.999 para o SRMR, 0.847 para o CFI e 0.847 para o TLI.
Essa etapa inicial avalia especificamente a sensibilidade dos índices globais de ajuste à má especificação estrutural. Cumpre ressalvar que a adequação amostral para o teste de ajuste global não assegura, isoladamente, a precisão assintótica na recuperação pontual de parâmetros ou na cobertura de intervalos de confiança (Feng & Hancock, 2023; Pornprasertmanit et al., 2022), justificando cautela na fixação do tamanho amostral definitivo.
4.4 SMC com tamanho amostral fixo
Considerando os resultados das curvas de poder e a necessidade de resguardar a precisão das estimativas sob desvios de normalidade e dados omissos, adota-se \(N=200\) como tamanho amostral prudencial de planejamento no presente tutorial.
A análise com tamanho amostral fixo emprega 1.000 replicações para cada condição populacional. Na primeira, simulam-se dados consistentes com o modelo de referência; na segunda, os dados incorporam as três cargas cruzadas, mantendo-se a estimação pelo modelo parcimonioso. Diferentemente da fase anterior, na qual dez replicações foram distribuídas em múltiplos tamanhos amostrais, essa etapa concentra todas as 1.000 replicações em \(N=200\). Essa concentração assegura estimativas mais estáveis do poder estatístico e das distribuições empíricas dos índices de ajuste para esse patamar específico.
NotaComo as simulações com N fixo foram realizadas
Finalidade
Gerar as distribuições dos índices de ajuste nas condições de referência e alternativa com 200 participantes por replicação.
Preparação
Utilize as mesmas especificações popmodel, h1model e analyzemodel e os parâmetros P_MCAR, DIST e SEED do planejamento anterior. As constantes SIM = 1000 e N_TARGET = 200, definidas em helpers.R, estabelecem o número de replicações e o tamanho amostral fixo.
Procedimento
As duas chamadas a sim() mantêm a estimação de analyzemodel, variando a população de origem pelo argumento generate. Cada condição concentra 1.000 replicações em N = 200, com os mesmos momentos marginais não normais, 10% de respostas ausentes MCAR, MLR, FIML e identificação por variâncias latentes unitárias. A semente e o processamento paralelo seguem a etapa com N variável.
Execução e resultado
Execute o bloco para obter popmodel_fixed e h1model_fixed, utilizados nas distribuições dos índices, no cálculo do poder e dos limites calibrados e na comparação com limites tradicionais. cache_or_run() reaproveita os objetos em memória ou os arquivos popmodel_200.rds e h1model_200.rds, em Data/IntermediateData; na ausência deles, executa e salva as simulações. Orientações para recálculo constam no README.
Código
# Reuse or simulate the reference population at the target sample size.
popmodel_fixed <- cache_or_run("popmodel_200", {
  sim(
    SIM,
    n = N_TARGET,
    pmMCAR = P_MCAR,
    analyzemodel,
    generate = popmodel,
    indDist = DIST,
    std.lv = TRUE,
    lavaanfun = "cfa",
    estimator = "mlr",
    missing = "fiml",
    seed = SEED,
    multicore = TRUE
  )
})

# Reuse or simulate the alternative population at the target sample size.
h1model_fixed <- cache_or_run("h1model_200", {
  sim(
    SIM,
    n = N_TARGET,
    pmMCAR = P_MCAR,
    analyzemodel,
    generate = h1model,
    indDist = DIST,
    std.lv = TRUE,
    lavaanfun = "cfa",
    estimator = "mlr",
    missing = "fiml",
    seed = SEED,
    multicore = TRUE
  )
})
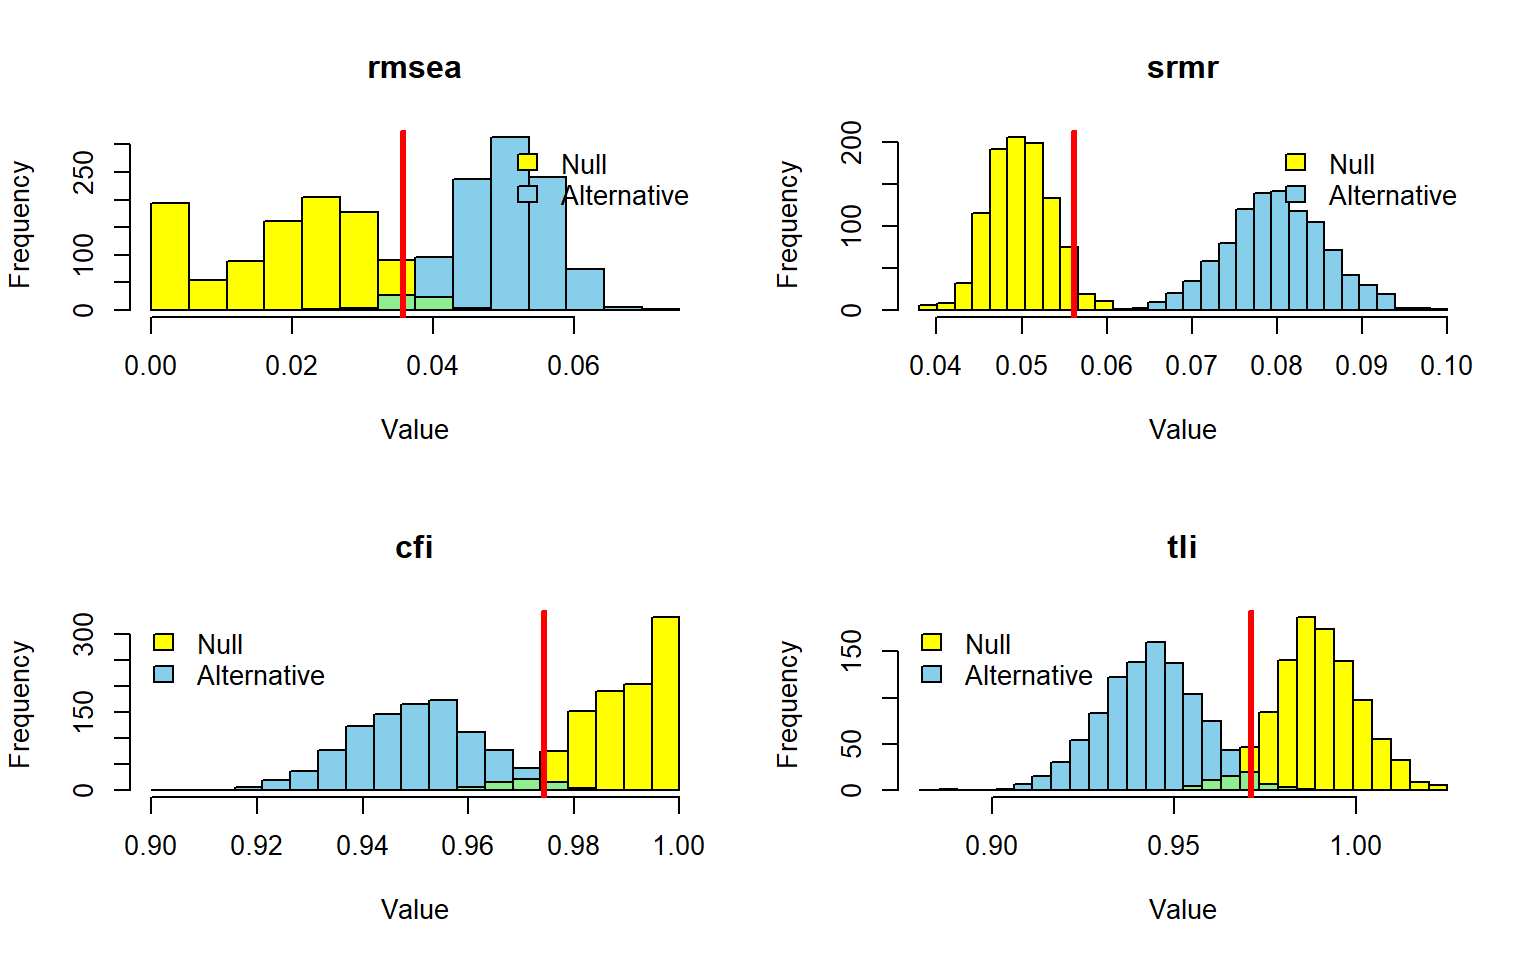
Com o tamanho amostral constante, dispensa-se a interpolação logística. A Figura 4.4 retrata diretamente o comportamento empírico dos índices nas duas condições populacionais. A separação entre as curvas ilustra a capacidade do teste em evidenciar a má especificação estrutural.
NotaRacional da Figura 4.4
Finalidade
Contrastar as distribuições empíricas dos índices de ajuste nas duas condições populacionais sob tamanho amostral fixado.
Preparação
Utilize popmodel_fixed e h1model_fixed, obtidos no callout “Como as simulações com N fixo foram realizadas”, além de ALPHA e FITS.
Procedimento
plotPowerFit() compara as distribuições empíricas dos índices selecionados em FITS nas duas condições populacionais. Como todas as replicações utilizam N = 200, a apresentação mostra as distribuições dos índices e seus limites calibrados, sem interpolação ao longo de diferentes tamanhos amostrais.
Execução e resultado
Execute o bloco para apresentar as distribuições dos índices a partir das simulações já disponíveis.
Código
# Plot the fit-index distributions at the target sample size.
plotPowerFit(
  h1model_fixed,
  popmodel_fixed,
  alpha = ALPHA,
  usedFit = FITS
)
Calculam-se, em seguida, o poder de detecção da má especificação e os pontos de corte correspondentes a RMSEA, SRMR, CFI e TLI. Esses limiares são calibrados a partir da distribuição empírica sob correta especificação, integrando simultaneamente tamanho amostral, desvios de normalidade, taxa de omissão e método de estimação. A Tabela 4.4 reúne os resultados para \(N=200\).
| RMSEA | SRMR | CFI | TLI | |
|---|---|---|---|---|
| Poder | 0.984 | 1.000 | 0.982 | 0.982 |
| Ponto de corte | 0.036 | 0.056 | 0.974 | 0.971 |
NotaRacional da Tabela 4.4
Finalidade
Apresentar o poder empírico e os limiares de corte calibrados para a simulação com 200 participantes.
Preparação
Utilize os objetos popmodel_fixed e h1model_fixed, obtidos no callout “Como as simulações com N fixo foram realizadas”.
Procedimento
O bloco estima o poder na condição alternativa e recupera os limiares na condição de referência, em consonância com a lógica da Tabela 4.3. Com tamanho amostral constante, dispensa-se o argumento nVal. A indexação por FITS ordena uniformemente os índices RMSEA, SRMR, CFI e TLI, assegurando alinhamento entre poder e pontos de corte.
readr::write_csv2() salva os valores sem arredondamento em Output/Results/Tables/tbl-power-cutoff-fixed.csv, com as linhas “Poder” e “Ponto de corte” identificadas na coluna Medida.
Execução e resultado
Execute o bloco para gerar a estrutura power_cutoff_fixed e compilar a tabela correspondente.
Código
# Estimate power using the calibrated cutoffs.
power_fixed <- getPowerFit(
  h1model_fixed,
  nullObject = popmodel_fixed,
  alpha = ALPHA,
  usedFit = FITS
)[FITS]

# Extract the model-calibrated cutoffs at the target sample size.
cutoff_fixed <- getCutoff(
  popmodel_fixed,
  alpha = ALPHA,
  usedFit = FITS
)[, FITS, drop = FALSE]

# Combine power and cutoffs in one table.
power_cutoff_fixed <- rbind(
  "Poder" = as.numeric(power_fixed),
  "Ponto de corte" = as.numeric(cutoff_fixed[1, ])
)

# Format the fit-index column labels.
colnames(power_cutoff_fixed) <- toupper(names(power_fixed))

# Save the table data as CSV.
readr::write_csv2(
  tibble::rownames_to_column(as.data.frame(power_cutoff_fixed), "Medida"),
  here::here("Output", "Results", "Tables", "tbl-power-cutoff-fixed.csv")
)

# Present the summary table.
kable(power_cutoff_fixed, digits = 3, align = "c")
4.5 Comparação com pontos de corte tradicionais
Por fim, compara-se o desempenho dos pontos de corte calibrados empiricamente com os limiares heurísticos tradicionais de ajuste global. Para RMSEA e SRMR, a rejeição ocorre quando as estimativas ultrapassam os limites teóricos estabelecidos; para CFI e TLI, verifica-se a rejeição quando os valores situam-se abaixo dos respectivos cortes.
A simulação com tamanho amostral fixo é reavaliada mantendo-se inalterados o tamanho amostral, as matrizes populacionais e as propriedades empíricas dos dados, modificando-se estritamente o critério de decisão. A Figura 4.5 exibe a classificação decorrente dos pontos de corte convencionais, e a Tabela 4.5 resume o poder resultante.
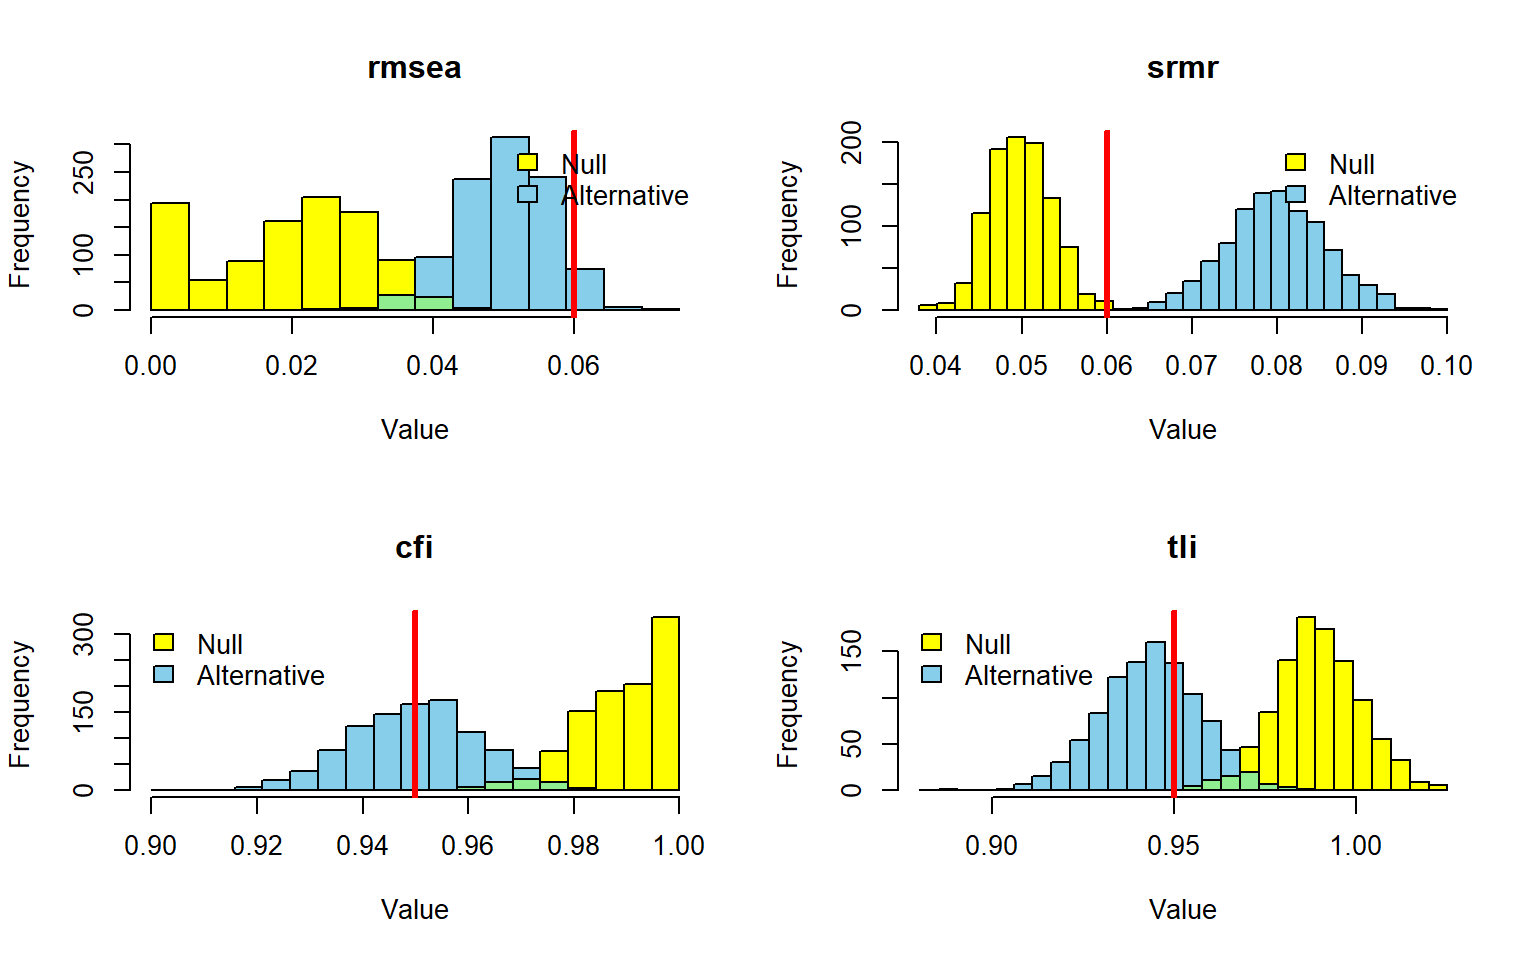
NotaRacional da Figura 4.5
Finalidade
Contrastar o poder resultante dos limiares tradicionais com os resultados fundamentados em cortes calibrados pelo modelo.
Preparação
Utilize os objetos popmodel_fixed, h1model_fixed e o vetor RULE_OF_THUMB, definido em helpers.R.
Procedimento
O gráfico reaproveita os objetos descritos no callout “Como as simulações com N fixo foram realizadas”, inserindo os limites convencionais pelo argumento cutoff = RULE_OF_THUMB. Os modelos, o tamanho amostral e as demais condições permanecem idênticos, alterando-se exclusivamente os limiares de avaliação.
Execução e resultado
Execute o bloco para renderizar o diagrama com as referências tradicionais, dispensando a geração de novas réplicas.
Código
# Plot power using conventional cutoffs.
plotPowerFit(
  h1model_fixed,
  popmodel_fixed,
  cutoff = RULE_OF_THUMB,
  alpha = ALPHA,
  usedFit = FITS
)| CFI | TLI | RMSEA | SRMR | |
|---|---|---|---|---|
| Poder | 0.496 | 0.678 | 0.062 | 1 |
NotaRacional da Tabela 4.5
Finalidade
Quantificar o poder estatístico sob os pontos de corte tradicionais para confrontação direta com os limiares empíricos calibrados.
Preparação
Utilize os objetos h1model_fixed, RULE_OF_THUMB e FITS, consolidados nas fases anteriores.
Procedimento
O cálculo injeta os limiares heurísticos no parâmetro cutoff. O vetor de poder retornado é estruturado em formato tabular, com cabeçalhos identificando cada índice. A operação reaproveita a condição alternativa com tamanho amostral fixado.
readr::write_csv2() salva os valores sem arredondamento em Output/Results/Tables/tbl-power-traditional.csv; a coluna Medida identifica a linha “Poder”.
Execução e resultado
Execute o bloco para compilar a estrutura power_traditional_tbl e exibir o poder estatístico associado às regras tradicionais.
Código
# Estimate power using conventional cutoffs.
power_traditional <- getPowerFit(
  h1model_fixed,
  cutoff = RULE_OF_THUMB,
  alpha = ALPHA,
  usedFit = FITS
)

# Arrange the power estimates in a single row.
power_traditional_tbl <- t(as.data.frame(power_traditional))

# Label the fit indices and power row.
colnames(power_traditional_tbl) <- toupper(names(power_traditional))
rownames(power_traditional_tbl) <- "Poder"

# Save the table data as CSV.
readr::write_csv2(
  tibble::rownames_to_column(as.data.frame(power_traditional_tbl), "Medida"),
  here::here("Output", "Results", "Tables", "tbl-power-traditional.csv")
)

# Present the summary table.
kable(power_traditional_tbl, digits = 3, align = "c")
Sob os pontos de corte tradicionais, o poder observado foi de 0.062 para o RMSEA, 1.000 para o SRMR, 0.496 para o CFI e 0.678 para o TLI.
Essa comparação evidencia que as regras de bolso convencionais geram diagnósticos substancialmente divergentes dos limiares calibrados por simulação, distorcendo a sensibilidade do teste à má especificação do modelo (Groskurth et al., 2024; McNeish & Wolf, 2023).
Dessa forma, as três etapas da AP cumprem funções complementares: a abordagem analítica fornece uma estimativa inicial fundamentada na discrepância populacional; a simulação com tamanho variável descreve a evolução da curva de poder entre 101 e 400 participantes; e a simulação intensiva com 1.000 replicações em \(N=200\) confere estabilidade assintótica ao planejamento amostral adotado.
Os pontos de corte derivados em \(N=200\) vinculam-se estritamente às premissas desse planejamento: parâmetros populacionais informados pela literatura empírica, desvios moderados de normalidade e 10% de dados omissos MCAR. Sua transposição para amostras com outras dimensões, distribuições ou configurações exige calibração específica. O resultado central dessa etapa reside na determinação do poder estatístico esperado para identificar a omissão estrutural planejada sob o cenário simulado.