| Prioridade de atenção na literatura | Item ou relação | Síntese das evidências na literatura |
|---|---|---|
| Alta | Q8 — segurança na vida diária | Apresenta ambiguidade entre os domínios ambiental e psicológico, com registros de cargas cruzadas, realocações e exclusões. É uma das divergências de alocação mais claras nas fontes consultadas. |
| Alta | Q10 — energia e fadiga | Há evidências de sobreposição entre os domínios físico e psicológico, expressas por cargas cruzadas e alocações alternativas. |
| Alta | Q14 — lazer | Apresenta registros de carga cruzada, realocação, exclusão e dependência residual com Q5, embora também tenha boa representação ambiental na síntese exploratória. |
| Alta | Q15 — mobilidade | Há registros de exclusão, inclusive em amostras de língua portuguesa, e de alocação em agrupamentos ambientais. Os achados indicam variação na representação da mobilidade entre contextos. |
| Moderada | Q3–Q4 — dor e necessidade de tratamento | Apresentam correlação residual recorrente e, em algumas soluções, formam uma dimensão própria. Sua retenção ou exclusão varia com o contexto clínico da amostra. |
| Moderada | Q5 — prazer de viver | Há registros de correlação residual com Q6 e Q14, alocação alternativa e exclusão em contextos específicos. A síntese exploratória também mostra forte representação do domínio psicológico. |
| Moderada | Q9 — ambiente físico | Apresenta registros de carga cruzada, correlação residual com Q8 e exclusão em contexto específico, indicando dificuldades na delimitação entre ambiente e percepção psicológica. |
| Moderada | Q19 — autoestima | Apresenta registros de correlação residual e alocações alternativas, ao lado de forte representação do domínio psicológico na síntese exploratória. |
| Moderada | Q26 — sentimentos negativos | Há registros de exclusão em diferentes contextos, embora a síntese exploratória também sustente sua representação no domínio psicológico. |
| Moderada | Q17–Q18 — atividades diárias e capacidade de trabalho | Há precedentes de covariância residual, cargas cruzadas e agrupamento em outra dimensão. A proximidade funcional e a dependência local constituem o argumento mais direto para a relação entre os itens. |
| Moderada | Q24–Q25 — acesso aos serviços e transporte | Há precedentes de correlação residual e de exclusão em uma solução reduzida, além de evidências de representação de ambos no domínio ambiental. |
| Moderada | Q12–Q13 — recursos financeiros e acesso à informação | Há precedentes de covariância residual entre os itens e de exclusão de ambos em uma solução reduzida. Os achados indicam variação na representação desses conteúdos ambientais. |
| Pontual | Q16 — sono e repouso | Há registro de exclusão em contexto específico. A evidência reunida oferece menor convergência para caracterizar uma dificuldade geral de representação. |
| Pontual | Q22 — apoio social | Há registros de exclusão em contextos específicos, mas a evidência reunida é menos consistente para caracterizar uma dificuldade geral de representação. |
8 Comparações e modificações dos modelos
8.1 Fundamentação das modificações
O diagnóstico da Seção 7, realizado na subamostra de calibração, destacou pontos de discrepância empírica que orientam modificações estruturais em H0. A definição das alterações conjuga a magnitude das cargas primárias, a demanda empírica por cargas cruzadas, as correlações residuais entre termos de erro e o conteúdo conceitual dos indicadores, alinhando-se aos precedentes da literatura. A Tabela 8.1 sintetiza as variações de representação fatorial catalogadas por Lin & Yao (2022) e por Mosqueira Taipe et al. (2026). O levantamento abrange também indicadores que serão preservados, proporcionando um panorama das dificuldades psicométricas documentadas para o instrumento.
Fontes: Lin & Yao (2022) e Mosqueira Taipe et al. (2026). Os estudos individuais são conhecidos por intermédio dessas sínteses.
Nota: A prioridade de atenção na literatura considera a recorrência dos registros e suas implicações para a interpretação do modelo, atribuindo maior peso às cargas cruzadas, seguido da exclusão de itens (cargas baixas) e das covariâncias residuais. A classificação avalia o conjunto das evidências de cada foco. A seleção reúne achados destacados pelas revisões e precedentes recorrentes ou considerados relevantes.
NotaRacional da Tabela 8.1
Finalidade
Apresentar a síntese bibliográfica que informa a avaliação das possíveis modificações do modelo.
Preparação
Utiliza-se o levantamento curado Data/InputData/whoqol_modification_evidence.csv, preparado e revisado antes dessa análise.
Procedimento
O bloco lê o arquivo em modification_evidence e apresenta uma linha por item ou relação, preservando os cabeçalhos e a ordem das prioridades. O levantamento é um insumo da análise: as fontes e a nota de classificação são informadas diretamente abaixo da tabela.
Execução e resultado
Execute o bloco para ler o levantamento e apresentar a tabela, sem gerar ou alterar a síntese bibliográfica.
Código
# Read the author-reviewed literature synthesis prepared before.
modification_evidence <- readr::read_csv2(
  here::here(
    "Data", "InputData", "whoqol_modification_evidence.csv"
  ),
  show_col_types = FALSE
)

# Print the table in Markdown format for Quarto rendering.
knitr::kable(
  modification_evidence,
  format = "pipe",
  align = c("l", "l", "l"),
  row.names = FALSE
)
A especificação modificada proposta para as análises subsequentes exclui os itens Q5, Q15 e Q24. Em Q5, a concentração de correlações residuais com Q6 e Q14 e as demandas de cargas cruzadas revelam dificuldades de delimitação dimensional. A literatura reporta essas dependências e alterações de alocação, ao passo que a síntese de Lin & Yao (2022) indica expressiva sobreposição com o domínio Psicológico. Sua exclusão responde diretamente às distorções locais detectadas na calibração. Quanto a Q15, a carga primária atenuada e a atração pelo domínio Meio Ambiente convergem com precedentes de eliminação em amostras lusófonas e propostas de alocação alternativa. O item Q24 conjuga carga reduzida e forte associação de erro com Q25, padrão igualmente documentado nos estudos prévios (Lin & Yao, 2022; Mosqueira Taipe et al., 2026).
Os itens Q3, Q4 e Q8 foram mantidos, nada obstante suas cargas modestas. Dor física e necessidade de tratamento médico representam facetas da saúde física cuja variância depende intrinsecamente do perfil clínico da amostra. A literatura relata a retenção de Q3 e Q4 em populações clínicas e sua eventual exclusão apenas em grupos jovens saudáveis. Preservam-se esses conteúdos conceituais e a covariância residual Q3–Q4 já contemplada na especificação original. Por sua vez, o item Q8 assegura a representação da segurança física no domínio Meio Ambiente. Sua proximidade empírica com o domínio Psicológico, apontada nas revisões, será considerada na interpretação do ajuste remanescente (Lin & Yao, 2022; Mosqueira Taipe et al., 2026).
Adicionou-se a covariância residual entre Q17 e Q18. A capacidade para o desempenho das atividades diárias e a aptidão laboral compartilham variância funcional específica, para além da dimensão física geral. A literatura documenta essa dependência residual em amostras de pacientes crônicos e de profissionais de saúde, sendo que o agrupamento conjunto desses indicadores em fatores funcionais específicos oferece evidência complementar dessa contiguidade. A inclusão desse parâmetro livre absorve a associação específica e viabiliza a permanência de ambos os itens no fator Físico (Lin & Yao, 2022; Mosqueira Taipe et al., 2026).
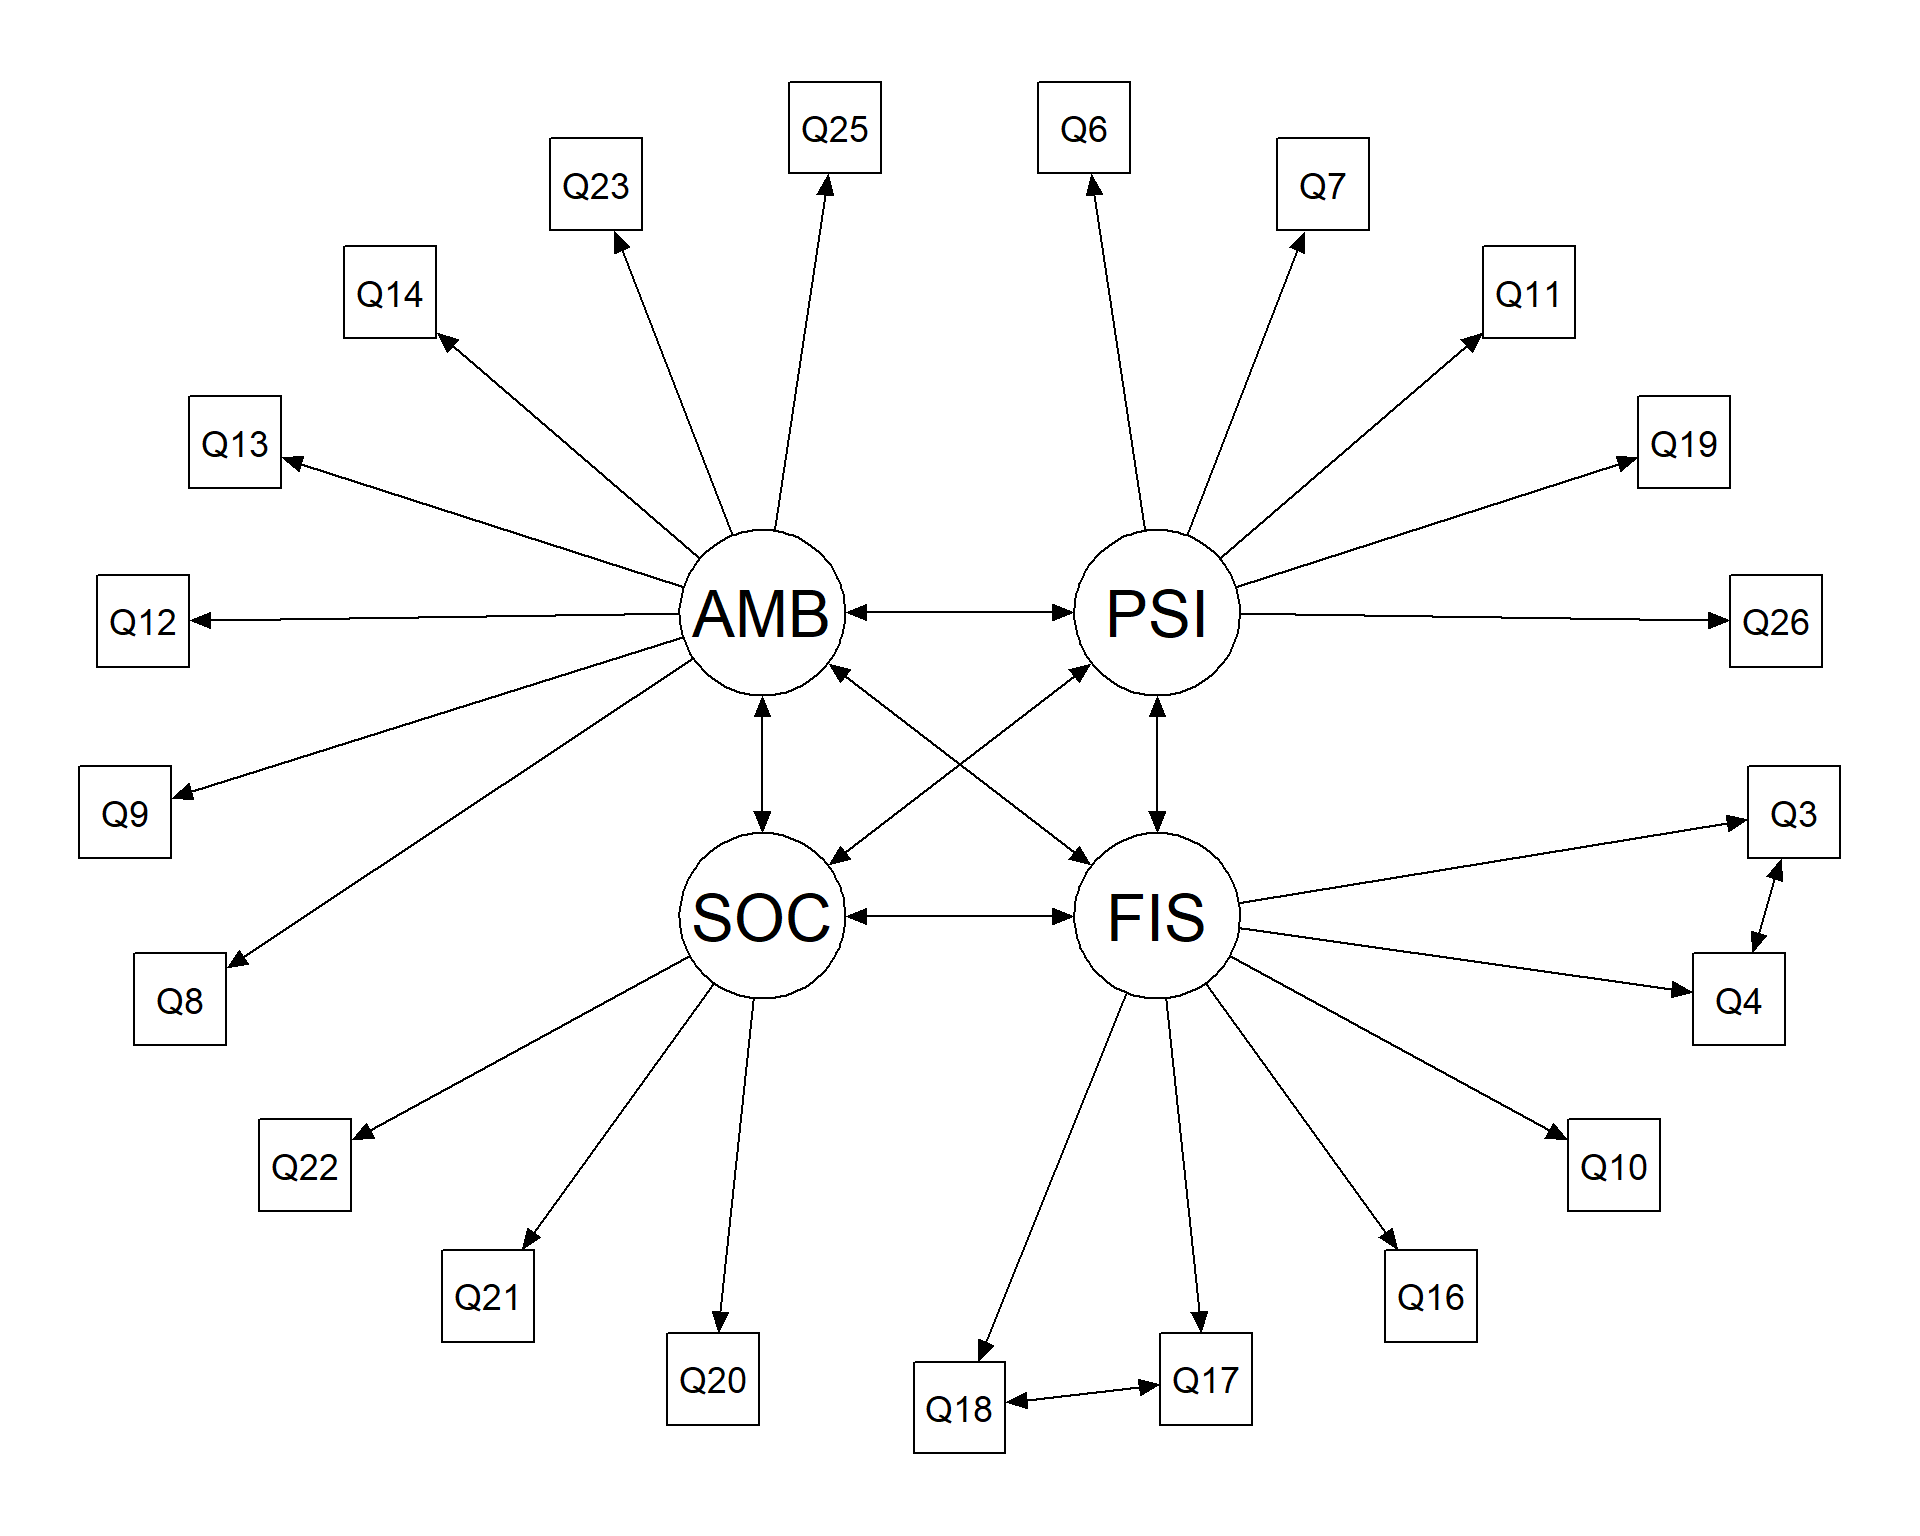
O modelo ajustado preserva quatro fatores correlacionados e os três indicadores sociais, passando a integrar 21 itens: 5 psicológicos, 6 físicos, 3 sociais e 7 ambientais. As exclusões suprimem a aferição direta de sentimentos positivos, locomoção e acesso aos serviços de saúde, devendo essa limitação acompanhar a interpretação dos escores. A formulação apoia-se nos diagnósticos da calibração e assume caráter exploratório. A especificação resultante é submetida ao teste confirmatório na subamostra de validação, avaliando-se o ajuste global, os desajustes locais e a confiabilidade compósita. A Figura 8.1 esquematiza a estrutura resultante com as covariâncias residuais especificadas.
NotaRacional da Figura 8.1
Finalidade
Representar a estrutura do modelo modificado antes de sua estimação.
Preparação
Utilizam-se adjustedzemodel, definido em models.R, e a rotina geral da Seção 3.
Procedimento
A chamada reutiliza plot_cfa() e as abreviações de LABELS, apresentados na Seção 3. O argumento color = "color" mantém as cores dos grupos; color = "BW" produz a versão em preto e branco. O argumento what_labels = "no" omite os valores nas relações, destacando a estrutura especificada.
Execução e resultado
Execute o bloco para apresentar o diagrama do modelo modificado.
Código
# Draw the adjusted model without numerical edge labels.
plot_cfa(adjustedzemodel, color = "BW", node_labels = LABELS, what_labels = "no")
8.2 Parâmetros estimados
O modelo modificado é estimado sobre os 622 participantes da subamostra de validação, mantendo idênticas as condições analíticas delineadas na Seção 6. A avaliação reporta os parâmetros livres, verifica a admissibilidade matemática e examina o ajuste global e local da especificação formulada na calibração. A Tabela 8.2 sintetiza os parâmetros do modelo modificado.
| Relação | Estimativa | EP | z | Padronizada |
|---|---|---|---|---|
| psycho =~ Q6 | 0.628 | 0.037 | 17.171 | 0.656 |
| psycho =~ Q7 | 0.556 | 0.034 | 16.532 | 0.649 |
| psycho =~ Q11 | 0.594 | 0.039 | 15.167 | 0.601 |
| psycho =~ Q19 | 0.777 | 0.027 | 28.306 | 0.843 |
| psycho =~ Q26 | 0.533 | 0.039 | 13.489 | 0.590 |
| physical =~ Q3 | 0.350 | 0.040 | 8.734 | 0.375 |
| physical =~ Q4 | 0.348 | 0.045 | 7.719 | 0.347 |
| physical =~ Q10 | 0.670 | 0.030 | 22.676 | 0.772 |
| physical =~ Q16 | 0.551 | 0.041 | 13.437 | 0.530 |
| physical =~ Q17 | 0.711 | 0.033 | 21.532 | 0.775 |
| physical =~ Q18 | 0.669 | 0.038 | 17.689 | 0.716 |
| social =~ Q20 | 0.707 | 0.033 | 21.174 | 0.787 |
| social =~ Q21 | 0.539 | 0.041 | 13.059 | 0.535 |
| social =~ Q22 | 0.637 | 0.036 | 17.779 | 0.716 |
| environment =~ Q8 | 0.490 | 0.043 | 11.264 | 0.504 |
| environment =~ Q9 | 0.563 | 0.040 | 14.045 | 0.619 |
| environment =~ Q12 | 0.755 | 0.043 | 17.630 | 0.683 |
| environment =~ Q13 | 0.512 | 0.040 | 12.913 | 0.609 |
| environment =~ Q14 | 0.667 | 0.039 | 17.259 | 0.692 |
| environment =~ Q23 | 0.433 | 0.041 | 10.515 | 0.477 |
| environment =~ Q25 | 0.463 | 0.044 | 10.557 | 0.472 |
NotaRacional da Tabela 8.2
Finalidade
Estimar o modelo modificado e apresentar suas cargas fatoriais.
Preparação
Utilizam-se a base Data/AnalysisData/whoqol_cv.csv, salva na Seção 6, e adjustedzemodel, disponível na preparação dessa seção conforme a orientação geral da Seção 3. O código seleciona sample_group == 1 em validation_data, recuperando a amostra de validação.
Procedimento
O bloco lê a partição salva e estima o modelo na amostra de validação, mantendo as condições de estimação da Seção 6. A função table_par(), apresentada no racional da Tabela 6.1, mantém a seleção padrão de cargas livres e os rótulos em português.
O atributo par_data disponibiliza os parâmetros completos para os valores inseridos no texto; table_data fornece a tabela de apresentação. Após verificar seu conteúdo, o bloco exporta as mesmas células exibidas, preservando rótulos, ordem e valores.
Execução e resultado
Execute o bloco para criar fit_adjustedzemodel, apresentar as cargas e salvar tbl-adjusted-parameters.csv em Output/Results/Tables. O ajuste alimenta os diagnósticos seguintes.
Código
# Read the saved partition created in Section 6.
cv_data <- readr::read_csv2(
  here::here("Data", "AnalysisData", "whoqol_cv.csv"),
  na = c("", "NA"),
  col_types = readr::cols(
    ID = readr::col_character(),
    missing_flag = readr::col_integer(),
    sample_group = readr::col_integer()
  ),
  show_col_types = FALSE
)

# Select the validation sample to evaluate the modified specification.
validation_data <- cv_data[cv_data$sample_group == 1L, ]

# Check that the adjusted model receives only the validation partition.
stopifnot(nrow(validation_data) > 0L,
  all(validation_data$sample_group == 1L))

# Fit the adjusted model using MLR/FIML and unit latent variances.
fit_adjustedzemodel <- lavaan::cfa(
  model = adjustedzemodel, data = validation_data, estimator = "MLR",
  missing = "fiml", std.lv = TRUE
)

# Prepare the formatted loading table in Portuguese.
parameter_table_adjusted <- table_par(fit_adjustedzemodel, lang = "pt")

# Preserve full-precision parameters for the values inserted in the text.
parameter_estimates_adjusted <- attr(parameter_table_adjusted, "par_data")

# Validate and export exactly the content displayed in the table.
parameter_table_data_adjusted <- attr(parameter_table_adjusted, "table_data")
if (!is.data.frame(parameter_table_data_adjusted) ||
    nrow(parameter_table_data_adjusted) == 0L) {
  stop("table_data is missing. Reload helpers.R and rerun this chunk.")
}
readr::write_excel_csv2(
  parameter_table_data_adjusted,
  here::here("Output", "Results", "Tables", "tbl-adjusted-parameters.csv"),
  na = "NA"
)

# Present the formatted loading table.
parameter_table_adjusted
As cargas fatoriais de Q3, Q4 e Q8 mantiveram-se modestas na validação: 0,375, 0,347 e 0,504, respectivamente. A decisão teórica de reter esses indicadores preserva os aspectos de dor, dependência terapêutica e segurança física. As magnitudes estimadas confirmam que tais facetas são capturadas apenas parcialmente pela estrutura latente comum. A validação sustenta a especificação fechada na calibração, englobando a covariância residual Q3–Q4 e parametrizando com transparência suas limitações operacionais.
O algoritmo convergiu plenamente para uma solução admissível, sem ocorrência de variâncias residuais negativas nem cargas padronizadas superiores à unidade. Esse diagnóstico atesta a regularidade matemática do ajuste, autorizando o avanço para a análise de ajuste global e local (Brown, 2015; Nye, 2022).
8.3 Ajuste global do modelo modificado
A Tabela 8.3 reporta os índices de ajuste global do modelo modificado: \(\chi^2\) com correção de escala, CFI, TLI e RMSEA robustos, intervalo de confiança de 90% do RMSEA e coeficiente SRMR, parametrizados para os 21 indicadores retidos.
| Medida | Valor |
|---|---|
| N | 622 |
| χ² ajust. | 437.311 |
| df | 181 |
| p-valor | < 0.001 |
| CFI (robusto) | 0.938 |
| TLI (robusto) | 0.928 |
| RMSEA (robusto) | 0.052 |
| RMSEA IC90% inf. | 0.046 |
| RMSEA IC90% sup. | 0.058 |
| p (RMSEA ≤ 0,05) | 0.294 |
| SRMR | 0.041 |
NotaRacional da Tabela 8.3
Finalidade
Organizar as medidas de ajuste global do modelo modificado.
Preparação
Utiliza-se fit_adjustedzemodel, estimado na subamostra de validação no bloco da Tabela 8.2. Esse procedimento reaproveita o referido ajuste, sem nova leitura de dados.
Procedimento
O procedimento aplica a função table_fit(), apresentada no racional da Tabela 7.1, ao ajuste modificado. As métricas completas são recuperadas em fit_data_adjusted e organizadas em vetor nomeado. A tabela de apresentação é conferida e exportada com idênticos rótulos, ordem e valores numéricos.
Execução e resultado
Execute o bloco para apresentar a síntese e salvar tbl-adjusted-model-fit-global.csv em Output/Results/Tables, sem repetir a estimação.
Código
# Prepare the formatted global fit table in Portuguese.
fit_table_adjusted <- table_fit(fit_adjustedzemodel, lang = "pt")

# Preserve full-precision measures for the values inserted in the text.
fit_data_adjusted <- attr(fit_table_adjusted, "fit_data")
fit_measures_adjusted <- stats::setNames(
  fit_data_adjusted$estimate, fit_data_adjusted$measure
)

# Validate and export exactly the content displayed in the table.
fit_table_data_adjusted <- attr(fit_table_adjusted, "table_data")
if (!is.data.frame(fit_table_data_adjusted) ||
    nrow(fit_table_data_adjusted) == 0L) {
  stop("table_data is missing. Reload helpers.R and rerun this chunk.")
}
readr::write_excel_csv2(
  fit_table_data_adjusted,
  here::here("Output", "Results", "Tables", "tbl-adjusted-model-fit-global.csv"),
  na = "NA"
)

# Present the formatted global fit table.
fit_table_adjusted
A especificação ajustada exibiu CFI robusto de 0,938, TLI robusto de 0,928, RMSEA robusto de 0,052 e SRMR de 0,041. As magnitudes mostram-se expressivamente mais favoráveis em comparação às estimativas das estruturas originais detalhadas na Seção 7. Como esse confronto engloba composições de indicadores e subamostras distintas, ele não configura teste formal de superioridade paramétrica. O foco analítico repousa na adequação confirmatória da especificação modificada perante os dados de validação. No tocante ao ajuste estreito, o teste da hipótese nula de RMSEA robusto \(\leq 0,05\) revelou \(p = 0,294\), não se rejeitando a hipótese de ajuste próximo na subamostra de validação.
8.4 Confiabilidade dos escores
A Tabela 8.4 expõe os coeficientes ômega e GLB calculados para os quatro escores com os 21 itens retidos. O ômega reproduz a parametrização do modelo modificado, incorporando as covariâncias residuais Q3–Q4 e Q17–Q18, ao passo que o GLB repousa na premissa algébrica de independência residual (Cho, 2022; Flora, 2020; Trizano-Hermosilla & Alvarado, 2016).
| Fator | Itens | Ômega | GLB |
|---|---|---|---|
| psycho | 5 | 0.798 | 0.823 |
| physical | 6 | 0.694 | 0.854 |
| social | 3 | 0.717 | 0.712 |
| environment | 7 | 0.780 | 0.838 |
NotaRacional da Tabela 8.4
Finalidade
Recalcular a confiabilidade dos escores correspondentes aos itens retidos no modelo modificado.
Preparação
Utiliza-se fit_adjustedzemodel, estimado na subamostra de validação no bloco da Tabela 8.2. Esse procedimento reutiliza o referido ajuste.
Procedimento
A chamada utiliza table_reliability(), apresentada no racional da Tabela 7.2. A composição de cada escore é obtida do ajuste modificado; ômega e GLB correspondem ao mesmo conjunto de itens em cada domínio.
O atributo reliability_data preserva coeficientes completos, composição dos escores e resultados nativos para consulta. O conteúdo de table_data é verificado e exportado com os mesmos rótulos e valores apresentados.
Execução e resultado
Execute o bloco para apresentar a confiabilidade e salvar tbl-adjusted-domain-reliability.csv em Output/Results/Tables, utilizando o ajuste existente.
Código
# Prepare the formatted score reliability table in Portuguese.
reliability_table_adjusted <- table_reliability(fit_adjustedzemodel, lang = "pt")

# Preserve full-precision coefficients for the values inserted in the text.
reliability_adjusted <- attr(reliability_table_adjusted, "reliability_data")

# Validate and export exactly the content displayed in the table.
reliability_table_data_adjusted <- attr(reliability_table_adjusted, "table_data")
if (!is.data.frame(reliability_table_data_adjusted) ||
    nrow(reliability_table_data_adjusted) == 0L) {
  stop("table_data is missing. Reload helpers.R and rerun this chunk.")
}
readr::write_excel_csv2(
  reliability_table_data_adjusted,
  here::here("Output", "Results", "Tables", "tbl-adjusted-domain-reliability.csv"),
  na = "NA"
)

# Present the formatted score reliability table.
reliability_table_adjusted
A reespecificação redefiniu a composição dos escores Psicológico, Físico e Meio Ambiente, mantendo-se intacto o fator Relações Sociais com seus três itens. Na subamostra de validação, os coeficientes ômega dos escores Psicológico, Social e Meio Ambiente suplantaram o limiar de 0,70. No domínio Físico, a estimativa fixou-se em 0,694, situando-se marginalmente abaixo dessa referência. Os índices GLB superaram 0,70 em todos os quatro domínios (Cho, 2022; Trizano-Hermosilla & Alvarado, 2016).
As estimativas de ômega oscilaram entre 0,694 e 0,798, enquanto os valores de GLB situaram-se entre 0,712 e 0,854. A interpretação desses números perante a estrutura original H0 deve considerar o estreitamento conceitual decorrente da exclusão de itens e a independência da amostra de teste.
8.5 Avaliação por 3DFI
A avaliação confirmatória da especificação ajustada na subamostra de validação fundamenta-se na metodologia 3DFI exposta na Seção 2.5. A calibração de pontos de corte dinâmicos qualifica o grau de ajuste aproximado mediante a indução controlada de discrepâncias médias absolutas nas correlações, sem necessidade de arbitrar trajetórias específicas de má especificação. Ao passo que a simulação descrita na Seção 7 confrontou o modelo com uma alternativa estrutural pré-determinada, o objetivo da presente análise consiste em mensurar a magnitude tolerável do desajuste residual remanescente (McNeish & Wolf, 2024). Trata-se de uma avaliação graduada da solução após o refinamento exploratório, respondendo a perguntas complementares: a distância em relação ao ajuste exato nas estruturas iniciais e o nível de concordância empírica aproximada no modelo modificado.
O procedimento simula 1.000 amostras com base nos 21 indicadores, incorporando as assimetrias distributivas empíricas sob o estimador MLR. Fixaram-se três níveis médios de discrepância absoluta (MAD): 0,038, 0,050 e 0,060, representativos dos patamares de ajuste estreito (close), aceitável (fair) e medíocre (mediocre), segundo as diretrizes de McNeish & Wolf (2024). A Tabela 8.5 consolida os pontos de corte dinâmicos para CFI, RMSEA e limite superior do intervalo de confiança de 90% do RMSEA.
| Referência | MAD | MAD simulado | CFI | RMSEA | RMSEA IC90% sup. |
|---|---|---|---|---|---|
| Próximo | 0.038 | 0.036 | 0.975 | 0.032 | 0.040 |
| Razoável | 0.050 | 0.048 | 0.924 | 0.058 | 0.064 |
| Medíocre | 0.060 | 0.058 | 0.875 | 0.076 | 0.082 |
NotaRacional da Tabela 8.5
Finalidade
Calibrar e apresentar limites de ajuste aproximado para o modelo modificado por discrepância direta.
Preparação
Utilizam-se validation_data e fit_adjustedzemodel, obtidos na Tabela 8.2 para a validação (sample_group == 1), além de SEED e do mecanismo de cache da rotina geral. A calibração dos limites é armazenada em Data/IntermediateData/dfi_adjusted.rds.
Procedimento
A função dynamic::DDDFI() implementa o 3DFI e recebe o modelo ajustado em model e a amostra de validação diretamente em data. O procedimento seleciona internamente os indicadores presentes no modelo. A chamada utiliza scale = "nonnormal", estimator = "MLR", 1.000 replicações e discrepâncias médias absolutas de 0,038, 0,050 e 0,060. A semente é fixada antes da simulação, e plot.dfi = FALSE desativa a produção dos gráficos internos.
cache_or_run() reutiliza o resultado disponível ou executa a calibração; antes de salvar um novo resultado, remove os dados simulados para reduzir seu tamanho. O arquivo compacto é então lido do disco e seu tamanho amostral é conferido contra validation_data.
A função table_3dfi() recebe essa calibração e retorna a tabela; sua auxiliar tidy_3dfi() organiza as referências próximo, razoável e medíocre. A apresentação reúne MAD solicitado e simulado, CFI, RMSEA e limite superior do IC de 90% do RMSEA, com três casas decimais e rótulos em português. A exportação utiliza table_data, preservando as células apresentadas.
Execução e resultado
Execute o bloco para obter ou reutilizar dfi_adjusted, apresentar os limites e salvar tbl-adjusted-dfi-cutoffs.csv em Output/Results/Tables. A calibração permanece disponível para a figura seguinte.
Código
# Reuse the saved DDDFI calibration or compute it when unavailable.
dfi_adjusted <- cache_or_run("dfi_adjusted", {

  # Set the random seed for the simulation.
  set.seed(SEED)

  # Run the direct-discrepancy calibration for the adjusted model.
  result <- dynamic::DDDFI(
    model = fit_adjustedzemodel,
    data = validation_data,
    scale = "nonnormal",
    estimator = "MLR",
    reps = 1000,
    MAD = c(0.038, 0.050, 0.060),
    plot.dfi = FALSE
  )

  # Remove simulated datasets before saving the calibration.
  result$simulated_data <- NULL

  # Return the compact simulation result for persistence.
  result
})

# Read the compact DDDFI calibration from disk.
dfi_adjusted <- readRDS(
  here::here("Data", "IntermediateData", "dfi_adjusted.rds")
)

# Check that the saved calibration matches the current validation sample size.
stopifnot(dfi_adjusted$n == nrow(validation_data))

# Format the calibrated DDDFI reference table.
dfi_table_adjusted <- table_3dfi(dfi_adjusted, lang = "pt")

# Export exactly the content displayed in the table.
dfi_table_data_adjusted <- attr(dfi_table_adjusted, "table_data")
readr::write_excel_csv2(
  dfi_table_data_adjusted,
  here::here("Output", "Results", "Tables", "tbl-adjusted-dfi-cutoffs.csv"),
  na = "NA"
)

# Display the calibrated reference table.
dfi_table_adjusted
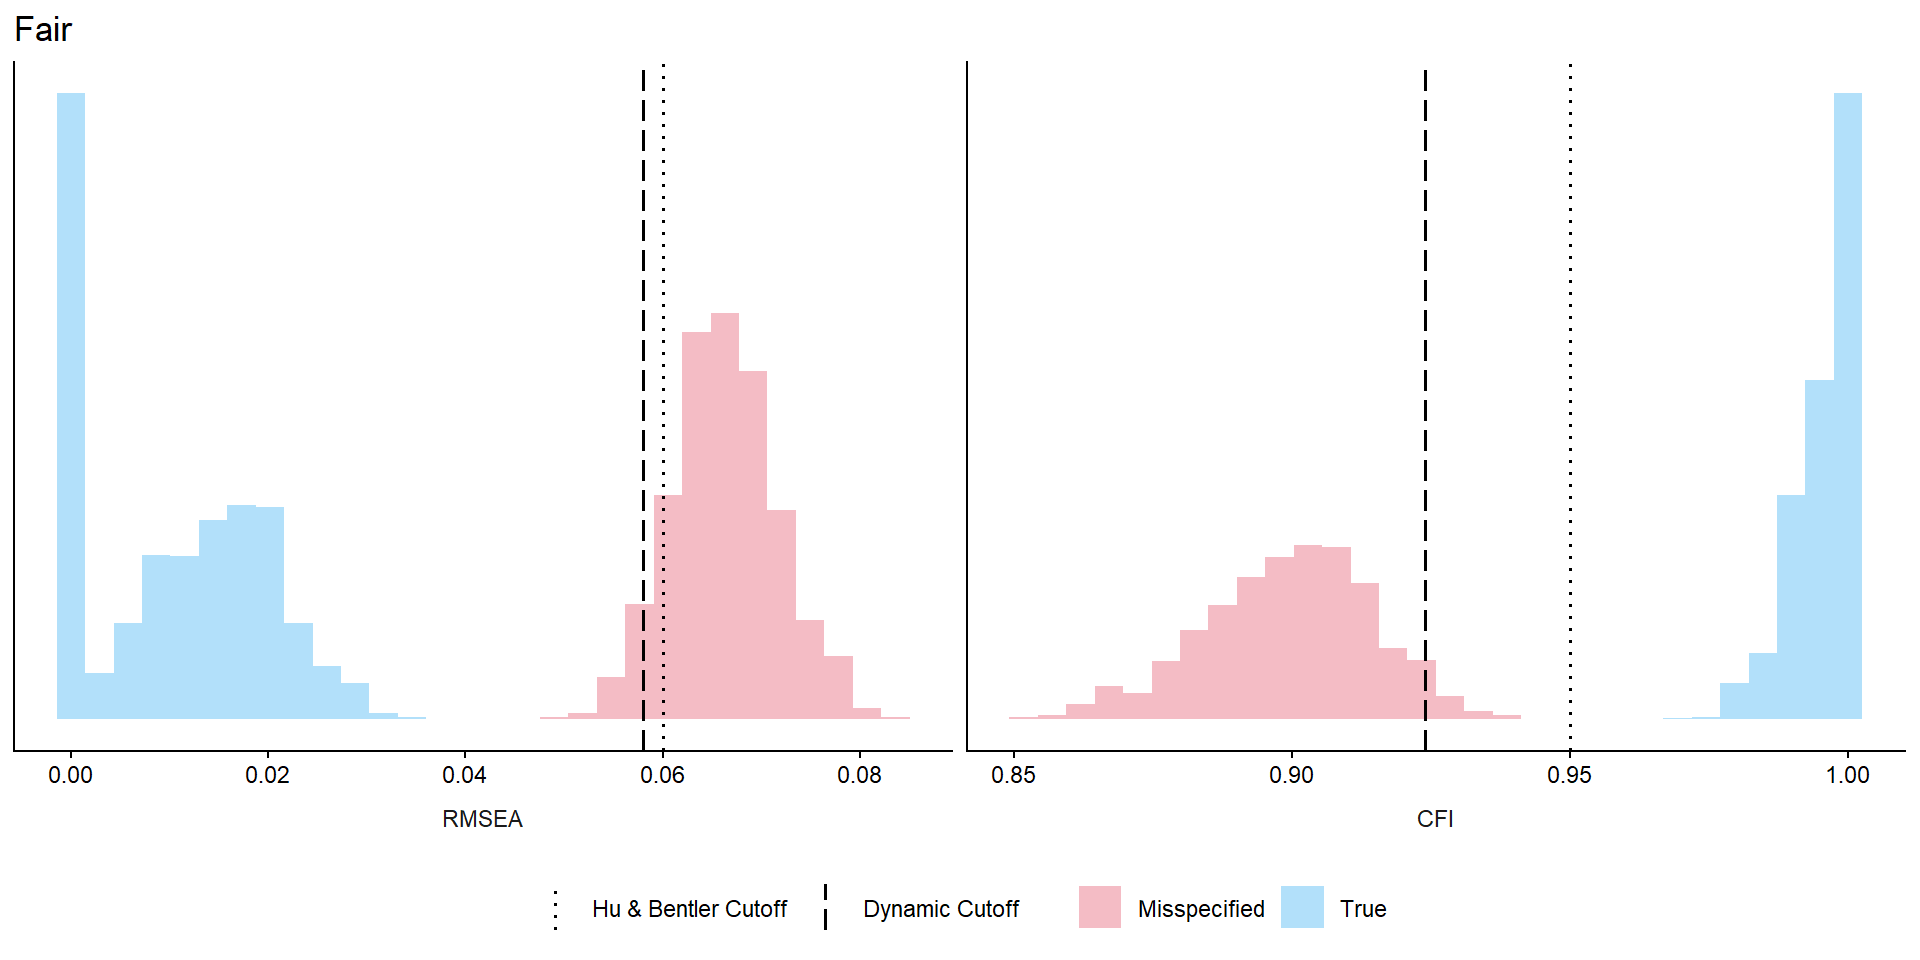
A Figura 8.2 ilustra a referência de ajuste aceitável (fair), confrontando as distribuições simuladas de CFI e RMSEA na condição nula e sob a perturbação programada. O contraste entre limites dinâmicos e referências convencionais demonstra a sensibilidade das métricas às propriedades empíricas da amostra.
NotaRacional da Figura 8.2
Finalidade
Comparar as distribuições simuladas de CFI e RMSEA sob referência e discrepância razoável, com limites calibrados e convencionais.
Preparação
Utiliza-se dfi_adjusted, obtido no bloco da Tabela 8.5. A reconstrução requer os índices persistidos em $indices.
Procedimento
A função plot_3dfi(), de helpers.R, recebe a calibração salva e a referência desejada: "Close", "Fair" ou "Mediocre". Essas opções selecionam, respectivamente, as distribuições CFI_L1/RMSEA_L1, CFI_L2/RMSEA_L2 ou CFI_L3/RMSEA_L3, sempre comparadas com CFI_L0 e RMSEA_L0. Na presente figura, adota-se reference = "Fair". As colunas SRMR_L* não são utilizadas: nessa implementação armazenam limites superiores do intervalo do RMSEA.
A função recupera os limites dinâmicos da linha correspondente à referência escolhida e acrescenta os valores convencionais CFI = 0,95 e RMSEA = 0,06. A figura sobrepõe histogramas e apresenta as linhas de corte em painéis separados. Os atributos plot_data e plot_cutoffs preservam os dados utilizados. Para examinar outro nível, altere apenas reference; por exemplo, plot_3dfi(dfi_adjusted, reference = "Mediocre").
Execução e resultado
Execute o bloco para apresentar dfi_plot_fair e salvar fig-dfi-adjusted-fair.png em Output/Results/Figures. O desenho utiliza a calibração salva, sem repetir a simulação.
Código
# Plot the saved distributions for the fair reference.
dfi_plot_fair <- plot_3dfi(dfi_adjusted, reference = "Fair")

# Display the simulated distributions and cutoff references.
print(dfi_plot_fair)

# Create the figure output directory if it is missing.
dir.create(
  here::here("Output", "Results", "Figures"),
  recursive = TRUE, showWarnings = FALSE
)

# Save the plotted figure at the requested dimensions and resolution.
ggplot2::ggsave(
  here::here("Output", "Results", "Figures", "fig-dfi-adjusted-fair.png"),
  plot = dfi_plot_fair, width = 10, height = 5, dpi = 300
)
Os coeficientes empíricos observados cumprem com folga os critérios da referência aceitável (fair): CFI de pelo menos 0,924, RMSEA de até 0,058 e limite superior do intervalo de confiança de 90% do RMSEA de até 0,064. A referência de ajuste estreito (close), mais rigorosa, não foi plenamente atingida. Desse modo, o procedimento 3DFI classifica o comportamento do modelo modificado como aceitável perante os dados de validação.
8.6 Diagnóstico local
O diagnóstico local mapeia os desajustes residuais remanescentes no modelo modificado sob a amostra de validação. A Tabela 8.6 elenca os vinte maiores MI acompanhados de seus respectivos EPC brutos e padronizados. Esses indicadores sinalizam o ganho potencial derivado da liberação isolada de parâmetros e devem ser cotejados com as cargas fatoriais e a matriz de resíduos (Crede & Harms, 2019; Nye, 2022).
| Relação | MI | EPC | EPC padronizado |
|---|---|---|---|
| Q8 ~~ Q9 | 38.123 | 0.169 | 0.282 |
| Q9 ~~ Q23 | 19.371 | 0.114 | 0.200 |
| Q17 ~~ Q22 | 18.096 | -0.062 | -0.171 |
| physical =~ Q6 | 17.080 | -1.197 | -1.251 |
| Q12 ~~ Q14 | 17.060 | 0.126 | 0.225 |
| Q20 ~~ Q12 | 14.926 | -0.093 | -0.208 |
| Q19 ~~ Q10 | 14.908 | -0.062 | -0.225 |
| social =~ Q6 | 13.327 | 0.234 | 0.245 |
| environment =~ Q10 | 12.885 | 0.184 | 0.212 |
| psycho =~ Q18 | 12.786 | 0.825 | 0.884 |
| Q9 ~~ Q12 | 12.119 | -0.102 | -0.176 |
| Q18 ~~ Q22 | 12.003 | 0.055 | 0.135 |
| Q19 ~~ Q3 | 11.631 | -0.063 | -0.147 |
| Q23 ~~ Q25 | 11.594 | 0.102 | 0.147 |
| Q8 ~~ Q13 | 11.534 | -0.086 | -0.154 |
| Q6 ~~ Q3 | 11.394 | -0.081 | -0.130 |
| social =~ Q26 | 11.212 | -0.211 | -0.233 |
| Q12 ~~ Q13 | 10.791 | 0.089 | 0.165 |
| social =~ Q7 | 9.959 | -0.182 | -0.212 |
| Q13 ~~ Q14 | 9.786 | 0.074 | 0.159 |
NotaRacional da Tabela 8.6
Finalidade
Examinar as vinte maiores relações candidatas à liberação após as modificações do modelo.
Preparação
Utiliza-se fit_adjustedzemodel, estimado na amostra de validação no bloco da Tabela 8.2. Esse procedimento reaproveita o referido ajuste.
Procedimento
O bloco aplica a função table_mi(), apresentada no racional da Tabela 7.3, ao ajuste modificado. O lavaan calcula e ordena os MI, com EPC bruto e padronizado, e exclui parâmetros já livres e MI indisponíveis. A rotina apresenta as primeiras vinte relações e formata a tabela.
O atributo mi_data preserva a saída completa do lavaan com precisão completa para uso no texto. Após a verificação de table_data, as mesmas vinte relações exibidas são exportadas. Os operadores lavaan são preservados no documento e como texto comum no CSV.
Execução e resultado
Execute o bloco para apresentar a tabela e salvar tbl-adjusted-modification-indices-top20.csv em Output/Results/Tables. A inspeção utiliza o ajuste fechado na validação e não libera novos parâmetros; suas sugestões não são aplicadas como novo refinamento nessa amostra.
Código
# Prepare the twenty largest modification indices in Portuguese.
mi_table_adjusted <- table_mi(fit_adjustedzemodel, lang = "pt")

# Validate and export exactly the content displayed in the table.
mi_table_data_adjusted <- attr(mi_table_adjusted, "table_data")
if (!is.data.frame(mi_table_data_adjusted) ||
    nrow(mi_table_data_adjusted) == 0L) {
  stop("table_data is missing or empty. Reload helpers.R and check the model.")
}
readr::write_excel_csv2(
  mi_table_data_adjusted,
  here::here(
    "Output", "Results", "Tables", "tbl-adjusted-modification-indices-top20.csv"
  ),
  na = "NA"
)

# Present the formatted modification index table.
mi_table_adjusted
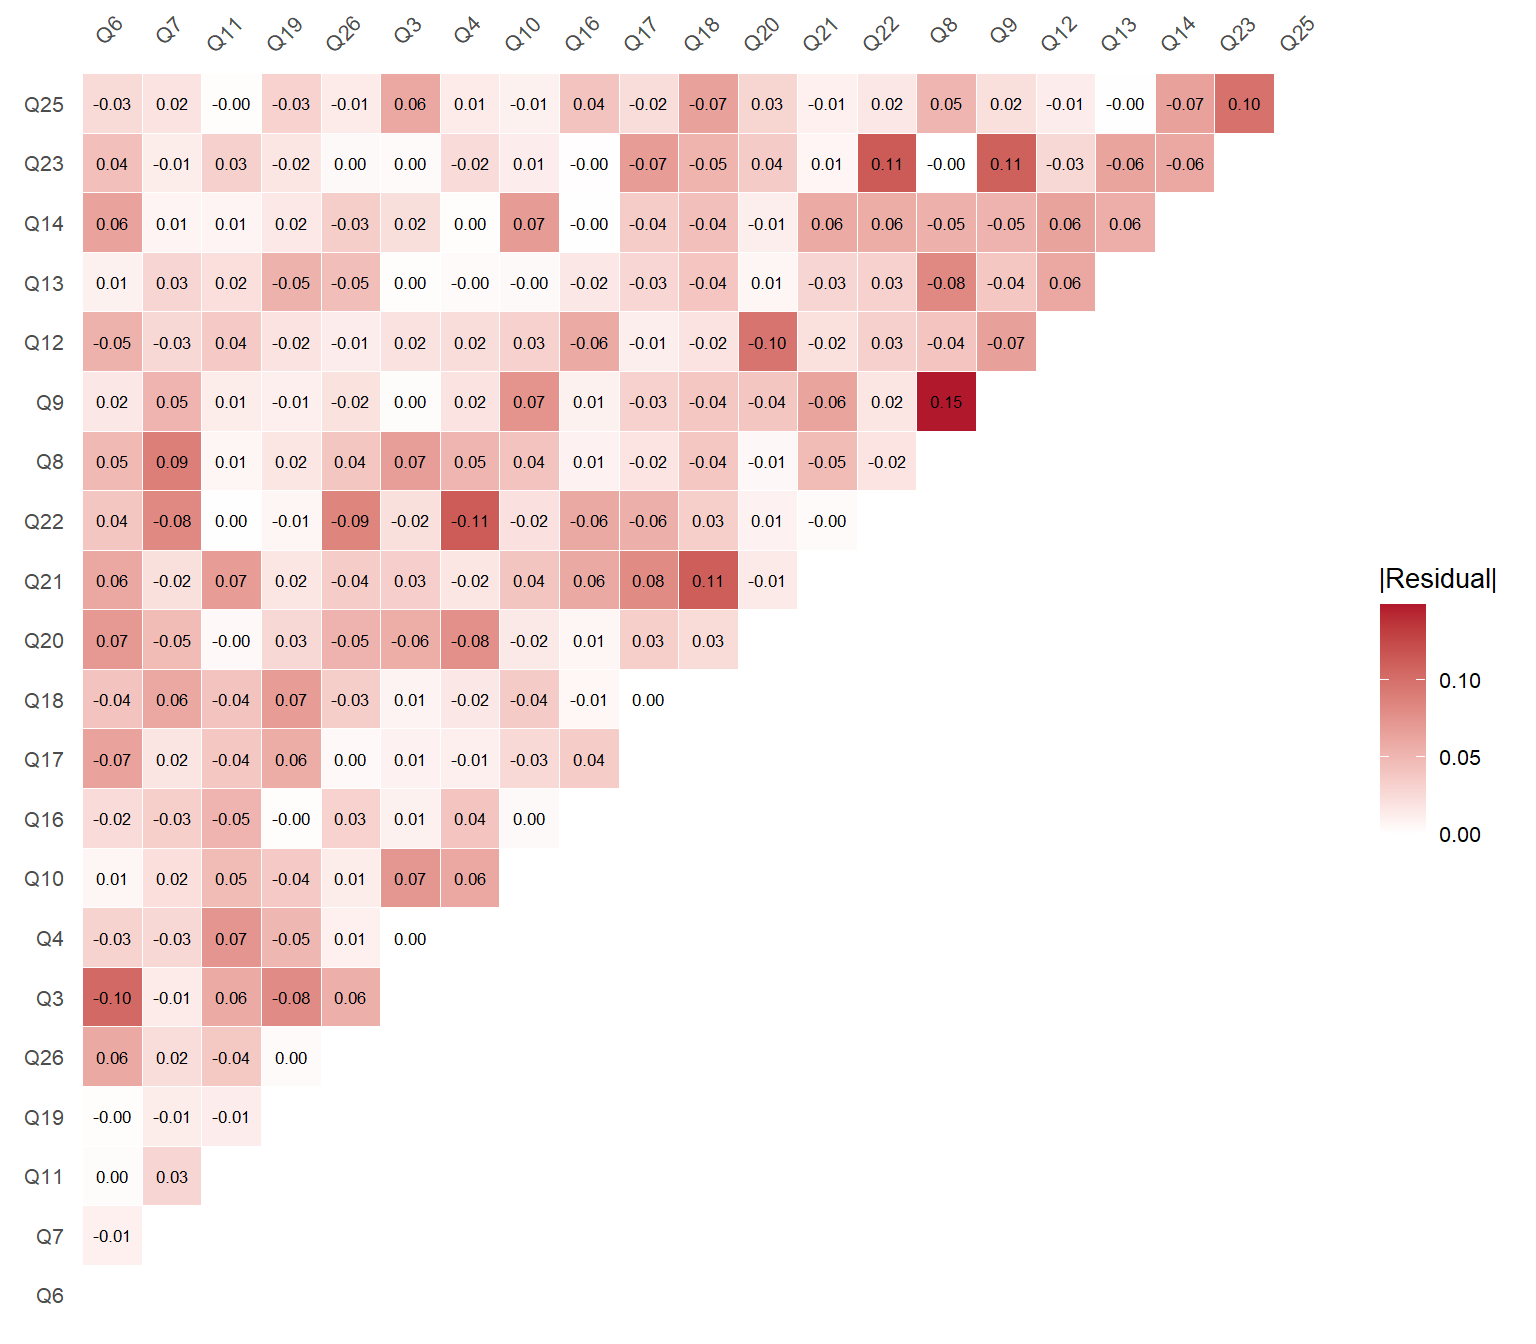
A Figura 8.3 exibe as divergências entre as correlações bivariadas observadas e aquelas reproduzidas pela estrutura de 21 itens. Cada par é representado uma única vez, associando-se a saturação de cor à magnitude absoluta do resíduo. O limiar prático de \(|r_{res}| \geq 0,10\) serve de guia para identificação dos pontos residuais de desajuste.
NotaRacional da Figura 8.3
Finalidade
Examinar as diferenças entre correlações observadas e reproduzidas pelo modelo modificado.
Preparação
Utilizam-se fit_adjustedzemodel, estimado na subamostra de validação no bloco da Tabela 8.2, e os parâmetros gerais da rotina.
Procedimento
A chamada aplica plot_stdres(), apresentada no racional da Figura 7.2, ao ajuste modificado. O mapa mantém a ordem dos indicadores, a cor pela magnitude absoluta e os rótulos com sinal. Os atributos preservam a matriz e os pares com precisão original para exportação e valores no texto.
Execução e resultado
Execute o bloco para apresentar o mapa e salvar residual-correlations-adjusted.csv em Output/Results/Tables e fig-residual-correlations-adjusted.png em Output/Results/Figures.
Código
# Create the correlation residual heatmap.
residual_heatmap_adjusted <- plot_stdres(fit_adjustedzemodel)

# Preserve full-precision residuals for export and inline results.
residual_matrix_adjusted <- attr(residual_heatmap_adjusted, "residual_matrix")
residual_correlations_adjusted <- attr(residual_heatmap_adjusted, "residual_data")

# Export the complete correlation residual matrix.
write.csv2(
  residual_matrix_adjusted,
  here::here("Output", "Results", "Tables", "residual-correlations-adjusted.csv"),
  row.names = TRUE, na = "NA"
)

# Save the residual correlation heatmap.
ggplot2::ggsave(
  here::here("Output", "Results", "Figures", "fig-residual-correlations-adjusted.png"),
  plot = residual_heatmap_adjusted, width = 8, height = 7, dpi = 300
)

# Display the residual correlation heatmap.
residual_heatmap_adjusted
O resíduo absoluto de maior magnitude fixou-se em 0,149, registrando-se que apenas 6 dos 210 pares avaliados ultrapassam o limiar prático de 0,10. A integração desse mapa com os parâmetros fatoriais e a tabela de MI/EPC delimita com clareza as discrepâncias remanescentes. O par Q8–Q9 lidera tanto o ranking de MI quanto a maior discrepância correlacional isolada, acompanhado de perto pela associação entre Q9 e Q23. A demanda de carga cruzada do item Q6 no fator Físico atinge EPC padronizado de -1,251, figurando entre as ressalvas diagnósticas documentadas. Cumpre salientar que esses índices projetam estimativas pontuais sob liberação univariada, não representando parâmetros de um modelo reajustado.
A reespecificação consolidou um modelo parcimonioso de quatro fatores com 21 indicadores, resguardando os três itens do domínio Social, mantendo a covariância de erro Q3–Q4 e incorporando a dependência entre Q17 e Q18. Na subamostra de validação, a solução satisfez os critérios de ajuste aceitável do 3DFI e não teve rejeitada a hipótese de ajuste próximo pelo teste do RMSEA. Os coeficientes ômega superaram 0,70 nos domínios Psicológico, Social e Meio Ambiente. No domínio Físico, o ômega ficou abaixo dessa referência, conforme reportado na análise de confiabilidade. Adota-se essa especificação, fundamentada na calibração e avaliada na validação, para orientar as conclusões metodológicas do estudo, recomendando-se cautela quanto à cobertura conceitual reduzida dos domínios.
8.7 Invariância de medida
A etapa conclusiva afere a estabilidade estrutural do modelo de 21 indicadores ao longo da partição amostral entre calibração e validação. A análise fatorial confirmatória multigrupo assegura a identificação simultânea de ambas as subamostras, examinando a comparabilidade dos parâmetros de mensuração. O nível configural afere se a configuração de fatores e indicadores mantém-se invariante entre os grupos, enquanto o nível métrico impõe restrições de igualdade sobre as cargas fatoriais não padronizadas (Fischer & Karl, 2019; Putnick & Bornstein, 2016).
Embora a invariância métrica seja condição suficiente para a estabilidade estrutural das cargas fatoriais, os níveis escalar e estrito estendem a avaliação, impondo sucessivamente a equivalência dos interceptos e das variâncias residuais (Putnick & Bornstein, 2016). Todas as especificações mantêm o estimador MLR/FIML e as covariâncias residuais Q3–Q4 e Q17–Q18 livres em cada subamostra.
NotaComo a invariância de medida foi configurada
Finalidade
Estimar os modelos configural, métrico, escalar e estrito para avaliar a invariância de medida entre calibração e validação.
Preparação
Utilizam-se adjustedzemodel, definido em models.R, e a partição persistida em Data/AnalysisData/whoqol_cv.csv. A preparação geral da seção disponibiliza os pacotes e a especificação do modelo de 21 indicadores.
Procedimento
O bloco recupera a base completa sem repetir a divisão. A variável sample_group identifica calibração (0) e validação (1), nessa ordem, com a calibração como referência. O argumento group solicita o ajuste multigrupo, mantendo as duas amostras identificadas.
As quatro chamadas utilizam MLR, missing = "fiml" e std.lv = TRUE. No configural, a mesma estrutura é estimada nos dois grupos sem restrições de igualdade entre eles. No métrico, group.equal = "loadings" iguala as cargas não padronizadas. O escalar acrescenta a igualdade dos interceptos, e o estrito acrescenta a igualdade das variâncias residuais. As covariâncias residuais Q3–Q4 e Q17–Q18 permanecem livres por grupo em todos os níveis.
Com std.lv = TRUE, as variâncias fatoriais são fixadas em 1 nos dois grupos no configural. A partir do métrico, as variâncias do segundo grupo são estimadas livremente; a partir do escalar, suas médias fatoriais também são livres. Essas condições identificam os modelos sem acrescentar igualdade de variâncias ou médias fatoriais entre os grupos.
Execução e resultado
Execute o bloco para criar fit_configural, fit_metric, fit_scalar e fit_strict. A estimação não apresenta os parâmetros individuais; os quatro objetos alimentam o bloco de comparação seguinte. Os ajustes configural e métrico também serão utilizados na permutação.
Código
# Read the saved partition without repeating the sample split.
cv_data <- readr::read_csv2(
  here::here("Data", "AnalysisData", "whoqol_cv.csv"),
  na = c("", "NA"),
  col_types = readr::cols(
    ID = readr::col_character(),
    missing_flag = readr::col_integer(),
    sample_group = readr::col_integer()
  ),
  show_col_types = FALSE
)

# Set calibration as the reference group.
cv_data$sample_group <- factor(cv_data$sample_group, levels = c(0, 1))

# Fit the same structure with parameters freely estimated in each group.
fit_configural <- lavaan::cfa(
  model = adjustedzemodel, data = cv_data, group = "sample_group",
  estimator = "MLR", missing = "fiml", std.lv = TRUE
)

# Constrain loadings while allowing the second group's factor variances to vary.
fit_metric <- lavaan::cfa(
  model = adjustedzemodel, data = cv_data, group = "sample_group",
  group.equal = "loadings",
  estimator = "MLR", missing = "fiml", std.lv = TRUE
)

# Add equal intercepts while allowing latent means to vary in the second group.
fit_scalar <- lavaan::cfa(
  model = adjustedzemodel, data = cv_data, group = "sample_group",
  group.equal = c("loadings", "intercepts"),
  estimator = "MLR", missing = "fiml", std.lv = TRUE
)

# Add equal residual variances while keeping residual covariances free by group.
fit_strict <- lavaan::cfa(
  model = adjustedzemodel, data = cv_data, group = "sample_group",
  group.equal = c("loadings", "intercepts", "residuals"),
  estimator = "MLR", missing = "fiml", std.lv = TRUE
)
A Tabela 8.7 apresenta os testes dos modelos e as diferenças robustas entre níveis hierárquicos. A avaliação considera o desajuste decorrente das restrições adicionais, distinguindo o teste de diferença da hipótese de ajuste exato de cada especificação sob correção robusta (Brown, 2015).
| Modelo | χ² ajust. | gl | Δχ² ajust. | Δgl | p da diferença |
|---|---|---|---|---|---|
| Configural | 834.452 | 362 | — | — | — |
| Métrico | 847.998 | 379 | 12.521 | 17 | 0.768 |
| Escalar | 869.482 | 396 | 18.625 | 17 | 0.350 |
| Estrito | 895.285 | 417 | 26.812 | 21 | 0.177 |
NotaRacional da Tabela 8.7
Finalidade
Apresentar o teste de cada modelo e os testes robustos das restrições acrescentadas entre níveis consecutivos de invariância.
Preparação
Utilizam-se fit_configural, fit_metric, fit_scalar e fit_strict, obtidos no bloco de estimação anterior. A função table_lrt() está definida em helpers.R.
Procedimento
A lista invariance_fits reúne os ajustes na ordem configural, métrico, escalar e estrito. Seus nomes identificam as linhas. table_lrt() utiliza tidy_lrt() para extrair o qui-quadrado ajustado de cada modelo e obter de lavaan::lavTestLRT() os testes robustos de diferença, sem subtrair diretamente as estatísticas ajustadas. Cada linha compara o modelo com o anterior; a primeira não possui teste de diferença. O valor-p refere-se à diferença, não ao teste global de cada modelo.
A apresentação inclui qui-quadrado, graus de liberdade, diferença de qui-quadrado, diferença de graus de liberdade e valor-p. AIC e BIC ficam omitidos por padrão; em outros usos, information = TRUE acrescenta essas colunas. As comparações pressupõem modelos aninhados sobre as mesmas variáveis e observações. O atributo lrt_data preserva os números completos e o resultado nativo do teste; table_data contém as células formatadas para exportação.
Execução e resultado
Execute o bloco para apresentar a tabela e salvar tbl-invariance-tests.csv em Output/Results/Tables. A lista invariance_fits será reutilizada na tabela seguinte.
Código
# Collect the nested models in increasing restriction order.
invariance_fits <- list(
  "Configural" = fit_configural, "Métrico" = fit_metric,
  "Escalar" = fit_scalar, "Estrito" = fit_strict
)

# Prepare the model tests and robust consecutive difference tests.
invariance_test_table <- table_lrt(invariance_fits, lang = "pt")

# Export exactly the displayed labels and cells.
readr::write_excel_csv2(
  attr(invariance_test_table, "table_data"),
  here::here("Output", "Results", "Tables", "tbl-invariance-tests.csv"),
  na = "NA"
)

# Display the model-comparison tests.
invariance_test_table
A restrição de igualdade sobre as cargas fatoriais foi sustentada pelos dados: o contraste entre os modelos métrico e configural exibiu \(\Delta\chi^2\) robusto de 12,521, com 17 graus de liberdade e \(p = 0,768\). As etapas subsequentes mostraram-se igualmente consistentes: os contrastes escalar/métrico e estrito/escalar retornaram \(p = 0,350\) e \(p = 0,177\), respectivamente. Esse padrão empírico respalda a invariância métrica e estrita da versão reduzida do instrumento (Putnick & Bornstein, 2016).
A Tabela 8.8 consolida a trajetória dos índices de ajuste e suas respectivas variações incrementais (\(\Delta\)).
| Modelo | CFI | ΔCFI | RMSEA | ΔRMSEA | SRMR | ΔSRMR |
|---|---|---|---|---|---|---|
| Configural | 0.943 | — | 0.050 | — | 0.040 | — |
| Métrico | 0.944 | +0.0005 | 0.048 | -0.0013 | 0.042 | +0.0028 |
| Escalar | 0.943 | -0.0002 | 0.047 | -0.0010 | 0.043 | +0.0005 |
| Estrito | 0.943 | -0.0007 | 0.047 | -0.0009 | 0.043 | +0.0004 |
NotaRacional da Tabela 8.8
Finalidade
Apresentar CFI e RMSEA robustos e SRMR, intercalados com suas mudanças entre níveis hierárquicos de invariância.
Preparação
Utilizam-se invariance_fits, organizado no bloco da Tabela 8.7, e table_fit_changes(), definida em helpers.R.
Procedimento
table_fit_changes() utiliza tidy_fit_changes() para extrair os índices dos ajustes e calcular as diferenças antes do arredondamento. As colunas alternam CFI/ΔCFI, RMSEA/ΔRMSEA e SRMR/ΔSRMR. Cada diferença corresponde ao modelo da linha menos o anterior: valores negativos de ΔCFI indicam queda, enquanto valores positivos de ΔRMSEA e ΔSRMR indicam aumento.
A família robusta de CFI/RMSEA acompanha a estimação MLR. O atributo fit_data preserva os valores completos e a família dos índices; table_data fornece as células exibidas.
Execução e resultado
Execute o bloco para apresentar a tabela e salvar tbl-invariance-fit-changes.csv em Output/Results/Tables. A função utiliza os ajustes existentes, sem reestimar modelos ou executar permutações.
Código
# Pair each fit index with its change relative to the preceding model.
invariance_fit_table <- table_fit_changes(invariance_fits, lang = "pt")

# Export exactly the displayed labels and cells.
readr::write_excel_csv2(
  attr(invariance_fit_table, "table_data"),
  here::here("Output", "Results", "Tables", "tbl-invariance-fit-changes.csv"),
  na = "NA"
)

# Display the indices and their signed changes.
invariance_fit_table
A especificação configural registrou CFI robusto de 0,943, RMSEA robusto de 0,050 e SRMR de 0,040. A fixação de igualdade sobre as cargas fatoriais aumentou o CFI em 0,0005 e atenuou o RMSEA em 0,0013, observando-se variação mínima no SRMR (0,0028). Esse comportamento indica que a imposição de invariância métrica não degradou a qualidade do ajuste.
Nos níveis escalar e estrito, os recuos observados no CFI fixaram-se em 0,0002 e 0,0007, valores inferiores ao limiar convencional de alerta de 0,010 (Chen, 2007; Cheung & Rensvold, 2002). O alinhamento entre os testes formais de diferença e a pequena magnitude das variações descritivas sustenta evidências de invariância de mensuração entre as amostras de calibração e validação (Putnick & Bornstein, 2016).
A equivalência métrica foi igualmente corroborada por teste de permutação estratificada para as variações de CFI, RMSEA e SRMR (Jorgensen et al., 2018). Para tanto, redistribuíram-se aleatoriamente os rótulos de calibração e validação dentro de cada estrato de integridade de dados (completos vs. omissos), reestimando-se os modelos configural e métrico para averiguar a probabilidade empírica de observar alterações adversas nos índices.
NotaComo a permutação da invariância métrica foi realizada
Finalidade
Obter uma referência empírica para as mudanças de CFI robusto, RMSEA robusto e SRMR ao impor igualdade das cargas entre calibração e validação.
Preparação
Utilizam-se fit_metric, fit_configural e cv_data, obtidos no bloco de estimação da invariância, além de SIM, SEED e cache_or_run() da preparação geral. O estrato original de ausência está registrado em missing_flag e foi definido pelos 24 indicadores antes da divisão amostral.
Procedimento
A função permute_within_strata alinha os grupos e os estratos à ordem dos participantes recuperada pelo ajuste, utilizando lavInspect(..., "case.idx"). Em cada repetição, os rótulos de calibração e validação são sorteados separadamente entre participantes completos e incompletos. Esse procedimento preserva as contagens originais de cada estrato por grupo, sem alterar respostas ou padrões de ausência. O argumento datafun substitui o embaralhamento irrestrito do pacote por essa redistribuição estratificada. local() mantém as informações necessárias junto da função.
As três chamadas a getFromNamespace() disponibilizam funções internas já existentes no semTools. Elas contornam uma falha de exportação do processamento por sockets na versão 0.5-7, sem modificar o pacote ou acrescentar análises.
semTools::permuteMeasEq() recebe o modelo métrico em con e o configural em uncon. A chamada solicita SIM permutações e compara as mudanças dos três índices. O processamento utiliza parallelType = "snow", 28 processos em ncpus e showProgress = FALSE. Esse modo utiliza sockets do pacote parallel; o número de processos pode ser ajustado à máquina. SEED define a semente utilizada no procedimento.
cache_or_run("perm_metric", ...) reutiliza primeiro o objeto disponível na sessão ou o arquivo Data/IntermediateData/perm_metric.rds. Na ausência de ambos, executa as permutações e salva o resultado. Alterar SIM, os modelos ou as condições da permutação não invalida automaticamente um resultado existente; a reutilização pressupõe correspondência com a análise atual.
Execução e resultado
Execute o bloco para obter perm_metric, que reúne as diferenças observadas, as distribuições de permutação, os valores-p empíricos e os registros de convergência. O resumo e os gráficos são apresentados no bloco seguinte. O código aparece uma única vez e é executável, com apresentação recolhível.
Código
# Align the original missingness strata with the data extracted by semTools.
permute_within_strata <- local({
  case_order <- unlist(lavaan::lavInspect(fit_metric, "case.idx"))
  original_group <- as.character(cv_data$sample_group[case_order])
  strata_rows <- split(seq_along(case_order), cv_data$missing_flag[case_order])

  # Replace unrestricted shuffling with random assignment within each stratum.
  function(data) {
    for (rows in strata_rows) {
      data$sample_group[rows] <- sample(original_group[rows])
    }
    data
  }
})

# Expose the internal functions exported by the semTools 0.5-7 socket backend.
permuteOnce.mgcfa <- getFromNamespace("permuteOnce.mgcfa", "semTools")
getAFIs <- getFromNamespace("getAFIs", "semTools")
getMIs <- getFromNamespace("getMIs", "semTools")

# Reuse the saved metric-invariance permutation or compute it when unavailable.
set.seed(SEED)

perm_metric <- cache_or_run("perm_metric", {
  semTools::permuteMeasEq(
    nPermute = SIM,
    modelType = "mgcfa",
    con = fit_metric,
    uncon = fit_configural,
    AFIs = c("cfi.robust", "rmsea.robust", "srmr"),
    datafun = permute_within_strata,
    # Disable the sequential progress loop and use socket workers.
    showProgress = FALSE,
    parallelType = "snow",
    ncpus = 28,
    iseed = SEED
  )
})
A Tabela 8.9 resume as variações observadas e os valores-\(p\) derivados das 1000 permutações empíricas, das quais 1000 alcançaram plena convergência numérica.
| Índice | Δ observado | p da permutação |
|---|---|---|
| CFI (robusto) | +0.0005 | 0.767 |
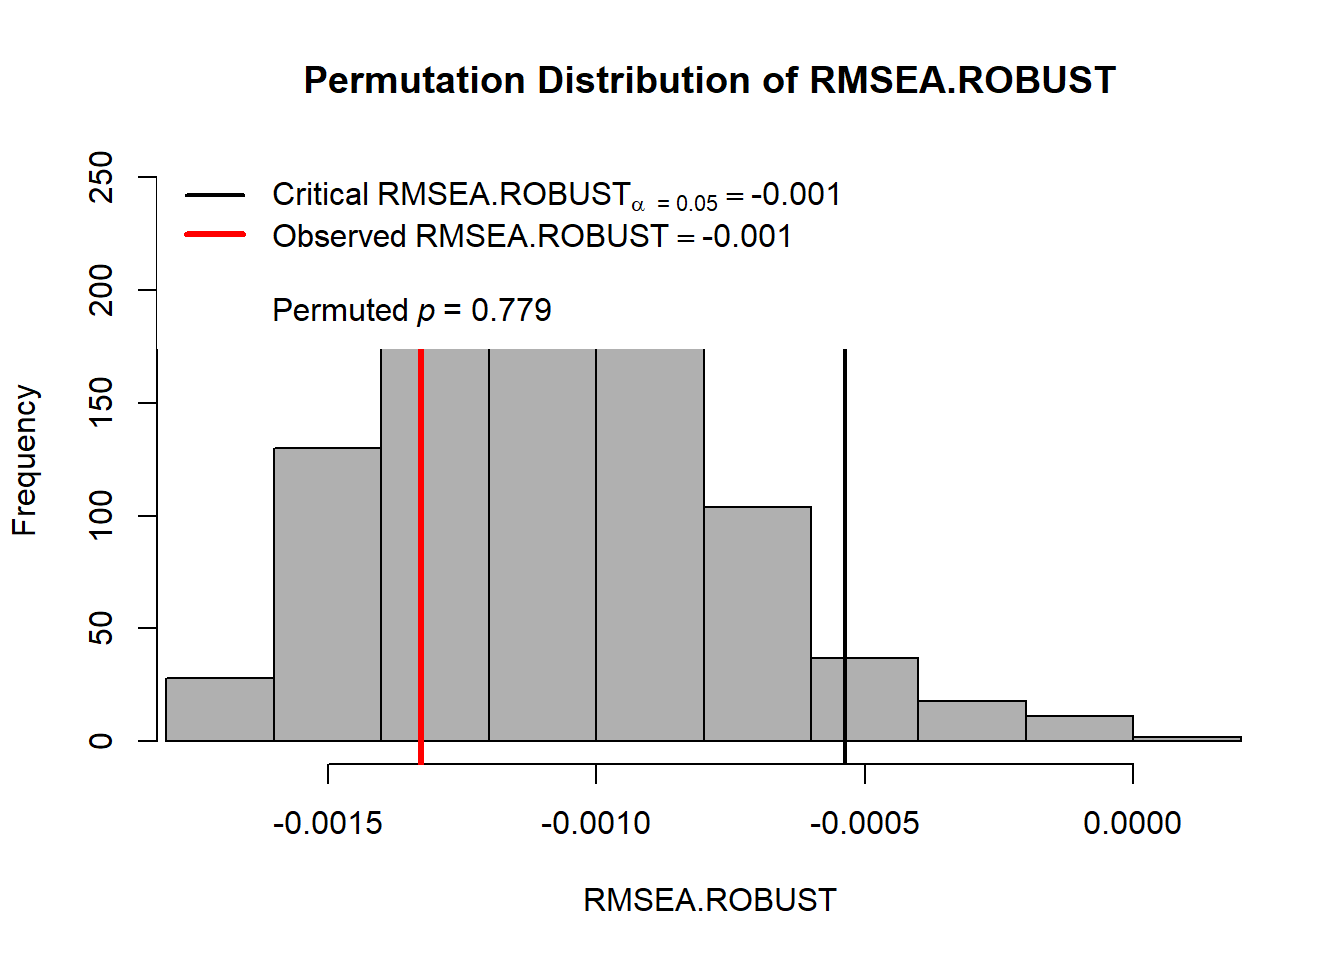
| RMSEA (robusto) | -0.0013 | 0.779 |
| SRMR | +0.0028 | 0.559 |
NotaRacional da Tabela 8.9
Finalidade
Apresentar as diferenças observadas dos índices e os valores-p empíricos do teste de invariância métrica por permutação.
Preparação
Utilizam-se perm_metric, obtido no bloco de permutação anterior, e table_permutation(), definida em helpers.R.
Procedimento
table_permutation() utiliza tidy_permutation() para extrair as diferenças observadas e os valores-p já calculados. As linhas apresentam CFI robusto, RMSEA robusto e SRMR. As diferenças correspondem ao modelo métrico menos o configural e são exibidas com quatro casas decimais e sinal; os valores-p são apresentados com três casas. A função não recalcula os testes nem executa novas permutações.
O atributo permutation_data preserva os valores completos, os nomes originais dos índices e as contagens de permutações solicitadas e convergentes. O atributo table_data contém as células formatadas utilizadas na exportação. Os valores-p referem-se à cauda de deterioração de cada índice: queda do CFI e aumento do RMSEA ou do SRMR.
Execução e resultado
Execute o bloco para apresentar permutation_table e salvar tbl-invariance-permutation.csv em Output/Results/Tables, com o mesmo conteúdo exibido.
Código
# Format the observed differences and empirical permutation p values.
permutation_table <- table_permutation(perm_metric, lang = "pt")

# Export exactly the cells displayed in the table.
readr::write_excel_csv2(
  attr(permutation_table, "table_data"),
  here::here("Output", "Results", "Tables", "tbl-invariance-permutation.csv"),
  na = "NA"
)

# Display the omnibus permutation results.
permutation_table
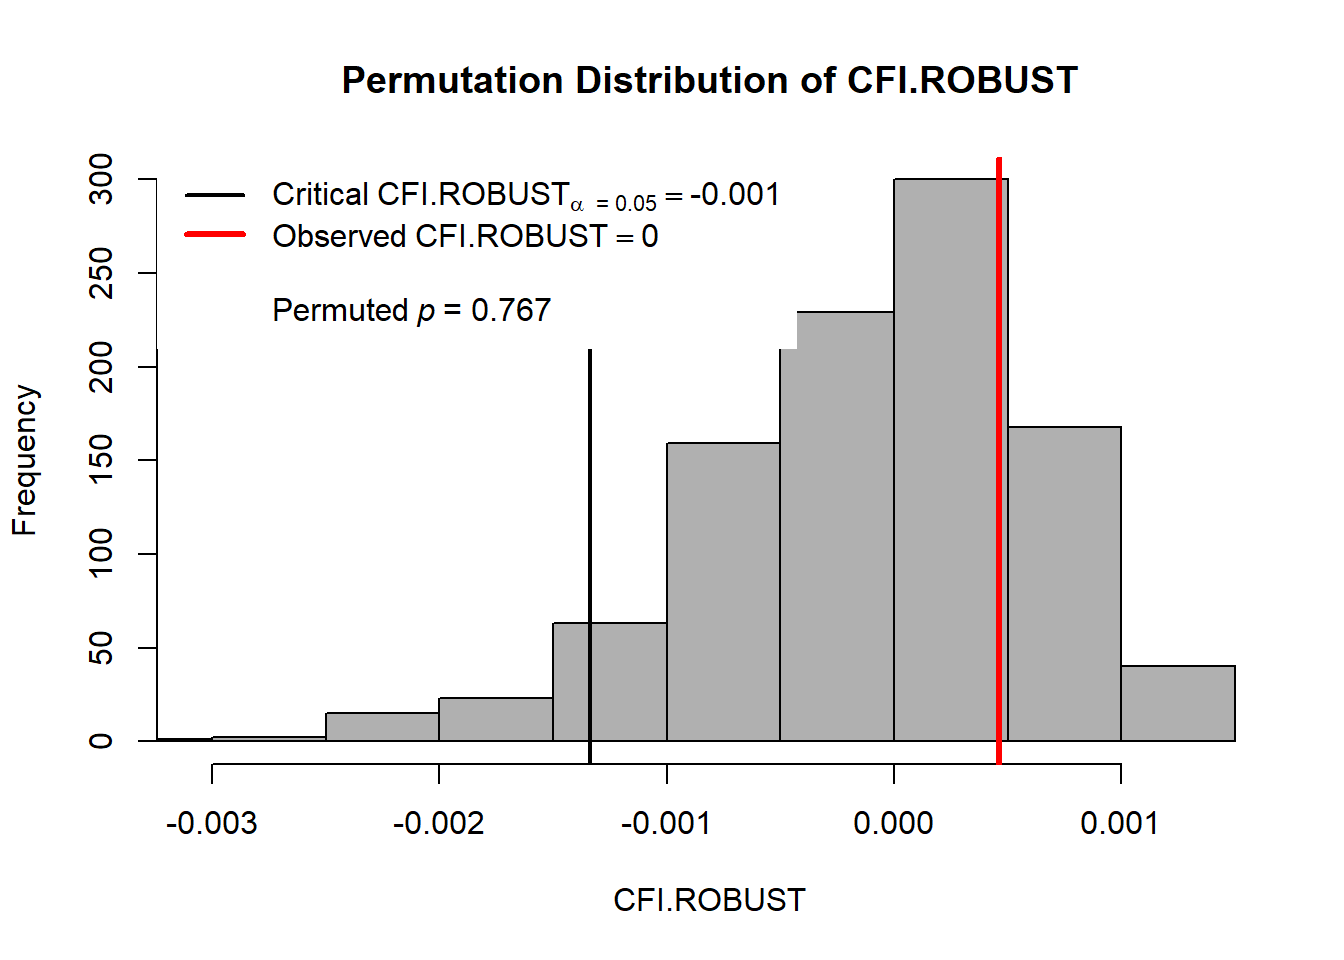
Os valores-\(p\) empíricos resultaram em 0,767 para o CFI robusto, 0,779 para o RMSEA robusto e 0,559 para o SRMR. As alterações observadas situaram-se bem distantes das regiões de cauda associadas à degradação do ajuste, em concordância com os resultados dos testes de razão de verossimilhanças (Jorgensen et al., 2018).
A Figura 8.4 ilustra as distribuições empíricas de \(\Delta\)CFI e \(\Delta\)RMSEA. As linhas tracejadas vermelhas demarcam os valores observados na amostra, ao passo que as linhas pretas sinalizam os pontos de corte críticos a 5%. Em ambos os casos, as estimativas empíricas permanecem afastadas da zona de rejeição.
NotaRacional da Figura 8.4
Finalidade
Visualizar as distribuições de referência das mudanças de CFI e RMSEA robustos e localizar as diferenças observadas no teste de invariância métrica.
Preparação
Utiliza-se perm_metric, obtido no bloco de permutação. Os histogramas acessam os resultados armazenados no objeto e não dependem da execução da tabela anterior.
Procedimento
As duas chamadas a hist() utilizam o método de semTools para o objeto de permutação. O argumento AFI seleciona cfi.robust ou rmsea.robust. Cada histograma mantém a apresentação nativa: frequências das diferenças permutadas, limite crítico empírico para α = 0,05, diferença observada e valor-p da permutação. Os valores nas legendas seguem o arredondamento padrão do método.
A linha vermelha identifica a diferença observada e a preta o limite crítico. Para o CFI, a deterioração corresponde à cauda inferior; para o RMSEA, à superior. O eixo horizontal representa a diferença entre modelos, embora o título nativo possa apresentar somente o nome do índice.
Execução e resultado
Execute o bloco para gerar os dois histogramas a partir das distribuições salvas. Renderize a seção para visualizar a figura composta com os painéis de CFI e RMSEA. Não são executadas novas permutações.
Código
A análise multigrupo conduzida entre as subamostras de calibração e validação sustentou evidências de invariância métrica da estrutura de 21 indicadores, com resultados igualmente favoráveis às restrições escalares e estritas. Esses resultados complementam as evidências de ajuste global, confiabilidade e diagnóstico local e indicam estabilidade interna entre parcelas da mesma base de dados. Seu alcance considera o histórico de seleção do modelo na amostra completa (Fischer & Karl, 2019; Putnick & Bornstein, 2016).